Вайбкодинг: От концепции до создания сложных приложений с помощью ИИ

Курс знакомит с новой парадигмой разработки, где фокус смещается с написания синтаксиса на управление контекстом и архитектурное видение. Вы пройдете путь от понимания работы LLM до сборки готовых программных продуктов без глубоких знаний традиционного программирования.

Что такое вайбкодинг: смена парадигмы от написания кода к дирижированию смыслами

Что такое вайбкодинг: смена парадигмы от написания кода к дирижированию смыслами

В начале 2025 года Андрей Карпаты, один из ведущих мировых исследователей искусственного интеллекта и бывший директор по ИИ в Tesla, написал: «Я больше не пишу код. Я пишу промпты». Это заявление стало манифестом новой эпохи. Если раньше для создания даже простейшего приложения требовались месяцы изучения синтаксиса языков программирования, то сегодня барьер между идеей и готовым продуктом сократился до умения ясно излагать свои мысли.

Добро пожаловать в эру вайбкодинга.

От синтаксиса к семантике

Традиционное программирование — это процесс перевода человеческих желаний на строгий, бескомпромиссный язык машин. Программист выступает в роли переводчика: он должен знать, где поставить точку с запятой, как правильно объявить переменную и как управлять памятью компьютера. Ошибка в одном символе может привести к краху всей системы.

Вайбкодинг (Vibecoding) — это подход к разработке программного обеспечения, при котором человек общается с машиной на естественном языке, описывая что нужно сделать, а искусственный интеллект (LLM) берет на себя задачу как это реализовать в виде программного кода.

Разница между этими подходами фундаментальна. Это переход от микроменеджмента к стратегическому управлению.

Характеристика Традиционное программирование Вайбкодинг
Главный инструмент Знание синтаксиса (Python, JS, C++) Естественный язык и логическое мышление
Роль человека Писатель строк кода, отладчик синтаксиса Архитектор смыслов, проверяющий результаты
Фокус внимания Как реализовать функцию технически Какую бизнес-задачу решает функция
Цена ошибки Пропущенная скобка ломает программу Неточная формулировка дает неверный результат

Вайбкодинг не убивает программирование. Он абстрагирует его на уровень выше. Точно так же, как языки высокого уровня (например, Python) когда-то избавили разработчиков от необходимости писать нули и единицы в машинном коде, нейросети сегодня избавляют нас от необходимости вручную писать рутинный код.

Почему именно «вайб»?

Слово «vibe» (атмосфера, настроение, энергетика) в названии термина появилось не случайно. При традиционной разработке вы не можете сказать компьютеру: «Сделай интерфейс более современным и уютным». Компьютер не понимает уюта, ему нужны точные значения отступов в пикселях и шестнадцатеричные коды цветов.

Нейросети, обученные на миллионах строк кода и дизайнерских решений, способны улавливать этот самый «вайб». Вы описываете высокоуровневую концепцию:

«Создай таймер Pomodoro. Он должен выглядеть как ретро-аркада из 90-х, с неоновыми цветами и пиксельным шрифтом. При окончании таймера кнопка должна пульсировать красным».

ИИ сам принимает решения о том, какие CSS-свойства использовать для создания неонового свечения, как подключить нужный шрифт и как написать JavaScript-функцию для пульсации. Вы передаете смысл и настроение, а машина генерирует техническую реализацию.

Новая роль: Дирижер смыслов

Если код пишет нейросеть, значит ли это, что человек больше не нужен? Напротив. Роль человека становится еще более важной, но она меняется. Вы перестаете быть «рабочим на конвейере» и становитесь «дирижером».

Вайбкодер выполняет три ключевые функции:

  1. Декомпозиция задачи. ИИ пока не может создать сложный аналог Facebook по запросу «сделай крутую соцсеть». Задачу нужно разбить на логические блоки: база данных пользователей, лента новостей, система лайков.
  2. Управление контекстом. Нейросети имеют ограниченную «память». Дирижер должен понимать, какие файлы и какую информацию нужно показать ИИ прямо сейчас, чтобы он написал правильный код. (Подробнее мы разберем это в главе про контекстное окно).
  3. Верификация и критика. ИИ часто галлюцинирует (ошибается, выдавая неверный код за правильный). Человек должен проверить результат, протестировать его и сказать нейросети: «Твоя функция сортировки работает, но она не учитывает пользователей без аватарок. Исправь это».

Итеративность: диалог вместо монолога

Вайбкодинг — это не одноразовый запрос к волшебной палочке. Это непрерывный диалог.

В классическом программировании вы долго пишете код, затем компилируете его и смотрите результат. В вайбкодинге цикл обратной связи сужается до секунд:

  1. Вы описываете идею.
  2. ИИ генерирует прототип.
  3. Вы смотрите на результат и пишете: «Слишком громоздко. Сделай кнопки меньше и добавь анимацию при наведении».
  4. ИИ мгновенно переписывает код.

Этот процесс называется итеративной разработкой. Вы лепите программу, как скульптор лепит из глины, постоянно отсекая лишнее и добавляя детали через уточняющие команды (промпты).

Резюме

Вайбкодинг демократизирует создание цифровых продуктов. Вам больше не нужно тратить годы на изучение синтаксиса языков программирования, чтобы создать свой первый проект. Однако это не значит, что думать больше не нужно.

Навык написания кода заменяется навыком системного мышления. Чем точнее, логичнее и структурнее вы мыслите, тем лучше код напишет для вас искусственный интеллект. В следующих главах мы заглянем «под капот» нейросетей, чтобы понять, как именно они читают ваши мысли и превращают их в работающие приложения.
Анатомия LLM для разработчика: как нейросети понимают инструкции и генерируют код

Анатомия LLM для разработчика: как нейросети понимают инструкции и генерируют код

Вы пишете: «Сделай кнопку красной и добавь анимацию пульсации при наведении». Через секунду на экране появляется безупречный CSS-код. Кажется, что внутри машины сидит невидимый программист, который читает ваше ТЗ, обдумывает его и печатает решение. На деле нейросеть не знает ни что такое «кнопка», ни что такое «красный цвет». Она вообще не понимает человеческий язык в нашем привычном смысле. Весь процесс вайбкодинга — от передачи высокоуровневого смысла до получения точного синтаксиса — опирается на строгую математику и теорию вероятностей.

Чтобы эффективно управлять этим процессом, дирижеру необходимо понимать, как устроен его оркестр.

Токенизация: как текст превращается в числа

Нейросети — это математические модели. Они не умеют работать с буквами или словами, они работают только с числами. Поэтому первый шаг при обработке вашего запроса — это разрезание текста на кусочки, которые называются токенами.

Токен не всегда равен одному слову. Частые слова могут быть одним токеном, а редкие или специфические термины разбиваются на слоги или даже отдельные буквы. В программировании это особенно заметно: синтаксические конструкции, пробелы и отступы тоже становятся токенами.

Рассмотрим классическую строку кода: console.log("Hello");

Для языковой модели (LLM) это не единая мысль, а последовательность из нескольких элементов:

  1. console
  2. .
  3. log
  4. ("
  5. Hello
  6. ");

Каждому такому кусочку в словаре модели присвоен уникальный числовой идентификатор. Ваш текстовый промпт превращается в длинный массив чисел. Именно с этого момента заканчивается лингвистика и начинается вычислительная геометрия.

Эмбеддинги: геометрия смыслов

Если слова превратились в абстрактные числа (например, console = 412, а log = 899), как нейросеть понимает, что они связаны по смыслу? И как она осознает, что слова «ошибка» и «баг» означают в контексте разработки одно и то же?

Здесь вступает в игру концепция эмбеддингов (векторных представлений).

Каждый токен проецируется в многомерное математическое пространство. Представьте себе огромную 3D-карту, где координаты определяют смысл слова. Слова, которые часто встречаются в похожих контекстах, притягиваются друг к другу и образуют кластеры.

В этом пространстве токены def (из Python) и function (из JavaScript) будут находиться очень близко друг к другу, потому что они выполняют одинаковую роль. А токен яблоко будет находиться бесконечно далеко от них, но зато рядом с груша или банан.

Эмбеддинг — это смысловой отпечаток слова. Модель не зубрит правила языков программирования, она вычисляет математическое расстояние между концепциями.

Именно благодаря этой геометрии вайбкодинг вообще возможен. Когда вы просите «сделать интерфейс более дружелюбным», модель ищет векторы, близкие к «дружелюбный интерфейс», и находит там токены, связанные с border-radius, box-shadow и мягкими цветами. Она переводит ваш абстрактный «вайб» в конкретные технические термины через измерение расстояний в этом пространстве.

Механизм внимания: почему важен контекст

Слова редко имеют фиксированный смысл. Возьмем слово «return». В промпте «Напиши функцию, которая делает return массива» — это ключевое слово синтаксиса. А в промпте «Добавь в корзину кнопку return (возврат товара)» — это элемент пользовательского интерфейса.

Как модель, состоящая из чисел, понимает разницу? За это отвечает механизм внимания (Self-Attention) — главное изобретение архитектуры Transformer, на которой построены современные LLM.

Механизм внимания заставляет каждый токен «смотреть» на все остальные токены в вашем запросе и вычислять, насколько они важны друг для друга.

  • В первом случае токен return обратит сильное внимание на слова функция и массив. Модель поймет: речь идет о программировании.
  • Во втором случае return свяжется с корзина и товар. Вектор смысла сместится в сторону электронной коммерции.

Чем точнее и богаче ваш промпт, тем лучше механизм внимания связывает разрозненные токены в единую, непротиворечивую картину. Если вы даете слишком короткую инструкцию, модель вынуждена угадывать связи, опираясь на усредненные данные из своего обучения, что часто приводит к галлюцинациям (генерации несуществующего или нелогичного кода).

Генерация: предсказание следующего шага

После того как модель перевела ваш запрос в числа, поняла смыслы через эмбеддинги и учла контекст через механизм внимания, начинается магия создания ответа.

Фундаментально, любая LLM делает только одну вещь: предсказывает следующий токен.

Это похоже на невероятно продвинутую систему Т9 в вашем смартфоне. Опираясь на весь предыдущий контекст (ваш промпт + то, что модель уже успела написать), она рассчитывает вероятности для каждого токена из своего словаря: какое слово должно идти дальше?

Допустим, модель сгенерировала: for (let i = 0; i Она рассчитывает вероятности следующего токена:

  • < — 85%
  • <= — 14%
  • > — 0.9%
  • + — 0.1%

Модель выбирает < и добавляет его к тексту. Затем процесс повторяется для следующего шага. Код рождается токен за токеном.

Температура: контроль над креативностью

Выбор следующего токена не всегда строго детерминирован (модель не обязана всегда брать вариант с максимальной вероятностью). Этим процессом можно управлять с помощью параметра, который называется Температура (TT).

  • Низкая температура (T0T \approx 0): Модель становится строгой и предсказуемой. Она всегда выбирает самый вероятный токен. Ответы становятся сухими, логичными и стабильными.
  • Высокая температура (T>0.7T > 0.7): В процесс добавляется случайность. Модель может выбрать менее вероятный токен. Это делает текст более разнообразным и «творческим».

В вайбкодинге понимание температуры критически важно. Если вы просите ИИ придумать архитектуру приложения или накидать идеи для игры — вам нужна креативность (высокая температура). Но когда вы просите написать строгий SQL-запрос или алгоритм шифрования, любая «креативность» приведет к синтаксической ошибке или уязвимости. Здесь нужна максимальная предсказуемость (низкая температура).

Понимание того, как токены складываются в векторы, как механизм внимания удерживает фокус, а вероятности диктуют генерацию, меняет ваше отношение к ИИ. Вы перестаете воспринимать нейросеть как человека-исполнителя, который может «догадаться» о ваших скрытых желаниях. Вы начинаете видеть в ней мощный математический инструмент.

И чтобы этот инструмент выдавал качественные приложения, ему нужно предоставить правильные исходные данные — то есть грамотно составить промпт и обеспечить нужный контекст.

Инструментарий новой эпохи: выбор и настройка сред разработки с поддержкой ИИ (Cursor, Windsurf)

Инструментарий новой эпохи: выбор и настройка сред разработки с поддержкой ИИ (Cursor, Windsurf)

Вы просите нейросеть написать компонент для сайта. Она выдает идеальный, казалось бы, фрагмент кода. Вы копируете его, вставляете в свой проект — и всё ломается. Кнопка съезжает, стили не применяются, а консоль выдает десяток ошибок об отсутствующих зависимостях. Проблема не в том, что нейросеть плохо предсказала токены. Проблема в том, что она предсказывала их в вакууме.

Чтобы вайбкодинг работал, ИИ должен жить внутри вашего кода, а не смотреть на него снаружи.

Эволюция инструментов: от чата к агенту

Взаимодействие разработчика с языковыми моделями прошло три быстрые стадии:

  1. Веб-чаты (ChatGPT, Claude в браузере). Вы вручную копируете куски своего кода, вставляете в окно браузера, описываете задачу, получаете ответ и несете его обратно. Модель не видит структуру папок, соседние файлы и конфигурации. Контекстное окно заполняется только тем, что вы сами догадались туда положить.
  2. Автодополнение (GitHub Copilot). Плагин встраивается в редактор. Когда вы пишете код, ИИ анализирует текущий открытый файл и предлагает продолжение строки или функции. Это ускоряет набор синтаксиса, но не позволяет передать высокоуровневый «вайб» — ИИ здесь лишь умная печатная машинка, а не дирижер.
  3. AI-native IDE (Cursor, Windsurf). Среды разработки, изначально спроектированные вокруг нейросетей. ИИ имеет доступ ко всей файловой системе, терминалу, истории коммитов и дереву зависимостей.

Когда вы просите AI-native IDE «добавить темную тему», модель сама находит файл со стилями, компонент переключателя, обновляет конфигурацию Tailwind и связывает это воедино. Она работает как автономный агент.

Сегодня стандартом вайбкодинга стали две среды разработки: Cursor и Windsurf. Обе построены на базе открытого исходного кода VS Code, поэтому все ваши привычные плагины, темы и настройки переносятся в них в один клик. Разница кроется в том, как именно они реализуют агентность.

Cursor: Первопроходец вайбкодинга

Cursor от компании Anysphere стал первым инструментом, который доказал жизнеспособность вайбкодинга для сложных проектов.

Его главная инновация — функция Composer (вызывается сочетанием Cmd+I или Ctrl+I). Это не просто чат, это интерфейс многофайлового редактирования. Вы описываете задачу на естественном языке, и Cursor анализирует, какие файлы нужно изменить.

Вместо того чтобы просто выдать текст ответа, Cursor генерирует diff (разметку изменений) и накладывает его поверх ваших реальных файлов. Вы видите красные (удаляемые) и зеленые (добавляемые) строки прямо в редакторе. Вы можете принять изменения целиком, отклонить их или точечно отредактировать предложенный код до сохранения.

Windsurf: Глубокое погружение и потоковое состояние

Windsurf, созданный компанией Codeium, вышел позже, но предложил следующий шаг в развитии концепции — систему Cascade.

Если Composer в Cursor — это отличный исполнитель, которому нужно давать четкие команды, то Cascade в Windsurf пытается быть полноценным напарником. Его ключевые отличия:

  • Осведомленность о терминале: Windsurf сам читает ошибки, которые выплевывает компилятор или локальный сервер. Если после генерации кода приложение упало, ИИ автоматически проанализирует лог ошибки в терминале и предложит исправление.
  • Многошаговые действия: Вы можете попросить «создай проект на React, установи нужные библиотеки и запусти сервер». Windsurf сам выполнит команды в терминале, дождется установки пакетов, напишет базовый код и запустит проект.

Что выбрать?

Критерий Cursor Windsurf
Подход к изменениям Пользователь жестко контролирует каждый диф и подтверждает файлы. ИИ более автономен, сам запускает команды и исправляет ошибки.
Интерфейс Composer в виде плавающего окна поверх кода. Cascade интегрирован в боковую панель с глубокой историей шагов.
Кому подойдет лучше Тем, кто хочет держать архитектуру под строгим ручным контролем. Тем, кто предпочитает делегировать рутину и настройку окружения.

Обе среды предоставляют бесплатные тарифы для старта. Выбор между ними — вопрос личного комфорта.

Настройка «мозга»: выбор правильной модели

Сама среда разработки (Cursor или Windsurf) — это лишь тело. Интеллект обеспечивается LLM (большой языковой моделью), к которой среда обращается по API.

В настройках обеих IDE вы можете выбирать, какую модель использовать для генерации. На данный момент безоговорочным лидером для написания кода является Claude 3.5 Sonnet от Anthropic.

В отличие от универсальных моделей (вроде GPT-4o от OpenAI), Claude 3.5 Sonnet демонстрирует выдающиеся способности в удержании контекста длинных файлов и реже страдает от «галлюцинаций» при работе со сложной логикой. Модель GPT-4o также доступна в IDE и отлично справляется с задачами, но вайбкодеры предпочитают Sonnet за его архитектурную точность.

В AI-native IDE параметр температуры генерации обычно скрыт от пользователя и жестко зафиксирован на низких значениях (ближе к нулю). Это гарантирует, что ИИ будет выбирать наиболее вероятные, синтаксически верные токены, не пытаясь креативить там, где нужна строгая логика работы программы.

Установив правильный инструмент и выбрав передовую модель, мы подготовили сцену. Среда разработки готова анализировать проект и вносить изменения. Дело за малым — научиться ставить задачи так, чтобы ИИ понимал ваш «вайб» с первого раза и не уводил архитектуру в тупик.

Искусство промпт-инжиниринга в кодинге: как формулировать задачи, чтобы получать работающий результат

Искусство промпт-инжиниринга в кодинге: как формулировать задачи, чтобы получать работающий результат

«Напиши мне форму авторизации» — это, пожалуй, самый частый и самый провальный запрос начинающего вайбкодера. В ответ AI-native IDE послушно сгенерирует код. Но это будет форма на устаревшем фреймворке, без валидации пароля, со стилями, которые сломают весь остальной дизайн приложения, и отправляющая данные в никуда. Инструмент сработал идеально, подвела постановка задачи.

В прошлой главе мы вооружились мощными средами разработки вроде Cursor и Windsurf. Но доступ к файловой системе сам по себе не гарантирует качества. Нейросеть — это вероятностная машина. Если вы оставляете смысловые пробелы, она заполняет их наиболее статистически частыми (и часто банальными или устаревшими) решениями из своей обучающей выборки. Чтобы управлять этим процессом, нам нужно перейти от языка желаний к языку инженерных спецификаций.

Анатомия инженерного промпта: фреймворк CTCE

Когда мы пишем код руками, мы держим в голове массу неявной информации: версию библиотеки, корпоративный стиль, архитектурные паттерны проекта. При работе с ИИ всё неявное должно стать явным.

Для структурирования запросов в вайбкодинге используется фреймворк CTCE: Context, Task, Constraints, Examples.

1. Context (Контекст)

Нейросети нужно понимать, в какой среде будет жить ее код. Механизм внимания (Self-Attention), который мы разбирали ранее, опирается на контекст, чтобы придать правильный смысл токенам. Вместо: «Сделай кнопку». Нужно: «Мы разрабатываем дашборд для финансовой аналитики на React. Эта кнопка будет находиться в панели фильтров и должна запускать пересчет графиков».

2. Task (Задача)

Что конкретно должно быть сделано. Глагол действия и ожидаемый результат. Вместо: «Нужна загрузка файлов». Нужно: «Реализуй компонент drag-and-drop для загрузки изображений форматов PNG и JPG, с отображением прогресс-бара».

3. Constraints (Ограничения)

Самая важная часть для получения работающего кода. Ограничения сужают пространство возможных решений, отсекая те, которые сломают ваш проект. Вместо: «Сделай адаптивно». Нужно: «Используй только классы Tailwind CSS. Не добавляй новые npm-пакеты. Не изменяй глобальный файл styles.css».

4. Examples (Примеры)

Показ желаемого результата или формата данных. Это переводит нас к следующей важнейшей концепции управления ИИ.

Управление вероятностями: Zero-shot и Few-shot

В машинном обучении есть два фундаментальных подхода к постановке задачи, которые напрямую влияют на качество генерируемого кода.

Zero-shot prompting (запрос с нулевым контекстом) — это когда вы даете задачу без примеров. Вы полагаетесь исключительно на внутреннюю базу знаний модели. Пример: «Напиши функцию для форматирования даты».

Few-shot prompting (запрос с несколькими примерами) — вы предоставляете модели образцы входа и выхода.

С математической точки зрения добавление примеров радикально меняет вероятности генерации нужных токенов:

P(AE)>P(A)P(A | E) > P(A)

Где P(AE)P(A | E) — вероятность получения корректного ответа AA при наличии примеров EE, а P(A)P(A) — вероятность без них. Примеры действуют как мощные магниты в векторном пространстве, притягивая генерацию к нужному стилю.

Характеристика Zero-shot Few-shot
Когда использовать Базовые алгоритмы, стандартные функции сортировки. Специфическое форматирование, парсинг нестандартных логов, сложный UI.
Риск галлюцинаций Высокий (модель додумывает формат). Низкий (модель копирует паттерн).
Пример промпта «Напиши регулярное выражение для поиска артикулов». «Найди артикулы. Пример входа: 'Товар AB-1234 куплен'. Выход: 'AB-1234'. Теперь обработай: 'Склад пополнил XY-9990'».

Chain of Thought: заставляем ИИ думать

Авторегрессионные модели генерируют текст токен за токеном, двигаясь только вперед. Если модель сразу начнет писать сложный код, она может загнать себя в логическую ловушку к середине функции, потому что у нее нет «черновика».

Чтобы избежать этого, применяется техника Chain of Thought (CoT) — цепочка рассуждений. Мы просим ИИ сначала описать план действий на естественном языке, и только потом писать код.

Добавление фразы «Let's think step by step» (давай подумаем пошагово) перед генерацией ответа радикально повышает точность на задачах рассуждения (например, с 10,4% до 40,7% на математическом бенчмарке), так как токены плана становятся контекстом для генерации финального результата.

Kojima et al., "Large Language Models are Zero-Shot Reasoners"

В вайбкодинге это реализуется так: «Прежде чем писать код, напиши нумерованный список шагов: как ты планируешь реализовать эту архитектуру. Дождись моего утверждения плана, и только потом генерируй код».

Эволюция одного запроса (Практика)

Давайте посмотрим, как абстрактная идея превращается в рабочий инструмент с помощью разобранных концепций.

Уровень 1 (Наивный промпт):

Сделай форму логина с email и паролем.

Результат: Модель напишет HTML-форму. Возможно, на чистом JS. Без стилей. Она не знает, куда отправлять данные.

Уровень 2 (Добавление контекста и задачи):

Мы делаем React-приложение. Напиши компонент логина с полями email и пароль. По клику на кнопку отправляй POST запрос на /api/login.

Результат: Уже лучше. Но модель может использовать библиотеку axios, которой у вас нет в проекте, и написать стили через обычный CSS, хотя весь проект использует Tailwind.

Уровень 3 (Инженерный промпт с CTCE и CoT):

Контекст: React-приложение (Next.js), авторизация через JWT. Задача: Создай клиентский компонент LoginForm.tsx для ввода email и пароля. Ограничения:

  • Используй только Tailwind CSS для стилизации.
  • Для запросов используй встроенный fetch, не добавляй axios.
  • Обработай состояния загрузки (кнопка должна блокироваться) и ошибки (показывать красный текст под полем). Пример: Внешний вид кнопки должен совпадать с нашим стандартом: className="bg-blue-500 hover:bg-blue-600 text-white px-4 py-2 rounded". Шаги: Сначала кратко опиши, какие стейты (useState) ты создашь, затем напиши сам код.

Получив такой запрос, AI-ассистент в Cursor или Windsurf выдаст production-ready компонент, который идеально встроится в ваш проект с первой попытки.

Мы научились формулировать идеальные задачи для создания отдельных компонентов. Но реальное приложение состоит из десятков файлов, связанных сложной логикой. Как объяснить нейросети архитектуру всего проекта, чтобы она не сломала роутинг, меняя кнопку? Это требует понимания того, как ИИ работает с памятью, что мы и разберем в следующей главе.

Контекстное окно и управление проектом: как объяснять ИИ структуру большого приложения

Контекстное окно и управление проектом: как объяснять ИИ структуру большого приложения

Вы составили идеальный промпт по фреймворку CTCE, прикрепили примеры, нажали Enter — и нейросеть выдала блестящий код. Но когда вы попытались запустить приложение, оно упало с ошибкой. Оказалось, что ИИ переписал функцию авторизации, но «забыл» обновить интерфейсы в соседнем файле, о существовании которого даже не подозревал. Это главная ловушка перехода от написания скриптов к созданию полноценных приложений: нейросеть не видит ваш проект целиком, пока вы ей его не покажете.

В прошлой главе мы научились формулировать задачи для генерации конкретных фрагментов кода. Теперь мы масштабируем этот навык. Разработка через вайбкодинг на уровне целого проекта — это искусство управления вниманием модели.

Физика кратковременной памяти ИИ

Чтобы понять, почему нельзя просто загрузить всю папку с проектом в чат и попросить «сделать хорошо», нужно вернуться к архитектуре LLM.

Как мы разбирали ранее, нейросети опираются на механизм внимания (Self-Attention), который оценивает связь каждого токена со всеми остальными. Математически вычислительная сложность этого процесса выражается формулой:

O(N2)O(N^2)

Где OO — это порядок сложности алгоритма (О-большое), а NN — количество токенов во входном запросе (промпте).

Это означает квадратичный рост: если вы увеличите объем передаваемого кода в 10 раз, вычислительная нагрузка на механизм внимания возрастет примерно в 100 раз.

Именно из-за этой математической особенности возникает физическое ограничение, называемое контекстным окном. Это максимальное количество токенов, которое модель способна удержать в «кратковременной памяти» за один запрос. Современные модели имеют окна от 128 000 до 200 000 токенов, а некоторые — до 1–2 миллионов (это сотни и тысячи страниц кода). Кажется, что этого хватит на весь проект. Но здесь вступает в игру психологический аналог работы ИИ — эффект «потери в середине».

Эффект "Lost in the Middle"

Исследования показывают, что LLM не усваивают информацию равномерно. Если загрузить в контекстное окно 50 файлов кода, модель отлично поймет файлы, переданные в самом начале (системные инструкции), и файлы в самом конце (ваш текущий запрос). Но код, оказавшийся в середине этого массива, с высокой вероятностью будет проигнорирован или понят искаженно.

Чем больше «шума» (нерелевантного кода) вы подаете на вход, тем слабее становится «сигнал» (код, который действительно нужно изменить). Поэтому главное правило вайбкодера при работе с архитектурой: минимизируйте контекст до необходимого и достаточного.

Воронка контекста: иерархия знаний о проекте

Чтобы обойти ограничения контекстного окна и эффект "Lost in the Middle", AI-native IDE (такие как Cursor или Windsurf) предлагают многоуровневую систему управления контекстом. Вы больше не скидываете файлы в кучу, а выстраиваете «воронку», где на каждом уровне отсекается лишнее.

Рассмотрим три главных уровня управления знаниями о проекте.

Уровень 1: Глобальные правила (.cursorrules)

Это фундамент вашей воронки. Файл .cursorrules (или .windsurfrules) лежит в корне проекта и автоматически добавляется в самое начало контекстного окна при каждом запросе.

Здесь не должно быть бизнес-логики. Сюда помещаются абсолютные константы и технологический стек.

Что писать в правилах:

  • Стек технологий (например: «Используем Next.js 14 с App Router, TypeScript, Tailwind CSS»).
  • Правила форматирования («Никаких any в TypeScript, всегда описывать интерфейсы»).
  • Архитектурные паттерны («Бизнес-логика должна быть отделена от UI-компонентов»).

Уровень 2: Системный контекст (Архитектурные Markdown-файлы)

Когда проект разрастается до десятков компонентов, ИИ должен понимать, как они связаны. Для этого вайбкодеры создают технические файлы-шпаргалки (например, ARCHITECTURE.md или DATABASE.md).

Вместо того чтобы скармливать модели 20 файлов с кодом базы данных, вы создаете один текстовый файл, описывающий структуру таблиц и связи между ними. Когда вы просите ИИ написать новый SQL-запрос, вы прикрепляете к контексту только этот DATABASE.md. Модель получает карту местности, не читая каждую травинку.

Уровень 3: Точечные ссылки (Символ @)

Это самый острый инструмент вайбкодера. В современных средах разработки символ @ позволяет явно указать модели, какие именно файлы нужно прочитать прямо сейчас.

Подход Результат Оценка
«Добавь поле 'возраст' в профиль пользователя» (без контекста) ИИ галлюцинирует структуру базы данных и ломает типизацию. ❌ Ошибка новичка
«Добавь поле 'возраст'» + прикрепление всей папки src ИИ долго думает, тратит токены и может изменить случайный файл из-за эффекта "Lost in the Middle". ⚠️ Неэффективно
«Добавь поле 'возраст'» + @UserProfile.tsx + @types.ts ИИ видит только интерфейс компонента и типы данных. Точечное, чистое изменение. ✅ Мастерство

Практический кейс: разделение монолитного компонента

Давайте посмотрим, как эти уровни работают вместе на классической задаче. У нас есть огромный файл Dashboard.tsx на 800 строк. Мы хотим, чтобы ИИ разбил его на три мелких компонента: Header, Chart и Table.

Если мы просто откроем Dashboard.tsx и напишем: «Разбей этот файл на компоненты», модель, скорее всего, создаст новые файлы, но запутается в импортах, потому что не знает, куда их положить.

Как мыслит вайбкодер:

  1. Глобальный контекст: Модель уже знает из .cursorrules, что мы используем TypeScript и определенную структуру папок.
  2. Формирование промпта: Мы открываем чат (или Composer) и собираем точечный контекст.
  3. Запрос:

    «Опираясь на архитектуру в @ARCHITECTURE.md, проведи рефакторинг @Dashboard.tsx. Вынеси логику графиков в новый компонент Chart.tsx, а таблицу в Table.tsx. Обязательно обнови интерфейсы в @types.ts, чтобы пропсы передавались корректно».

В этом запросе мы выступили как дирижеры. Мы не писали код, но мы строго ограничили сцену, на которой действует ИИ. Мы дали ему карту (ARCHITECTURE.md), исходный материал (Dashboard.tsx) и место для согласования типов (types.ts). В результате модель генерирует чистый Diff, не затрагивая остальное приложение.

Управление контекстным окном — это навык перевода ваших мыслей об архитектуре в формат, удобный для ограниченной памяти нейросети. Но даже при идеальном контексте модели свойственно ошибаться, придумывать несуществующие функции или путаться в версиях библиотек. Как выстроить процесс итеративной отладки и заставить ИИ самостоятельно исправлять свои баги — разберем на следующем шаге.

Итеративная разработка и отладка: что делать, когда нейросеть ошибается

Итеративная разработка и отладка: что делать, когда нейросеть ошибается

Представьте ситуацию: вы попросили ИИ добавить кнопку экспорта в PDF. Нейросеть радостно пишет код. Кнопка появляется, но при нажатии падает весь интерфейс. Вы пишете: «Интерфейс упал, исправь». ИИ извиняется, переписывает половину файла — теперь интерфейс работает, но отвалилась база данных. Вы снова просите исправить, и через двадцать минут обнаруживаете себя в руинах проекта, который до этой злосчастной кнопки прекрасно работал.

Ошибки при вайбкодинге неизбежны. Нейросети не обладают магическим всеведением, они — авторегрессионные модели, предсказывающие текст. Если вероятность безошибочно написать одну строку кода равна p=0.95p = 0.95 (95%), то вероятность написать идеальную функцию из n=20n = 20 строк вычисляется как Psuccess=pnP_{success} = p^n, то есть 0.95200.360.95^{20} \approx 0.36. Здесь pp — шанс на успех для одной строки, nn — количество строк, а PsuccessP_{success} — итоговая вероятность того, что весь блок кода сработает с первого раза. На практике это значит, что в 64% случаев (так как 10.36=0.641 - 0.36 = 0.64) в сложной функции будет хотя бы одна помарка.

Задача вайбкодера — не предотвратить все ошибки (это математически невозможно), а уметь быстро и эффективно выводить ИИ из тупика.

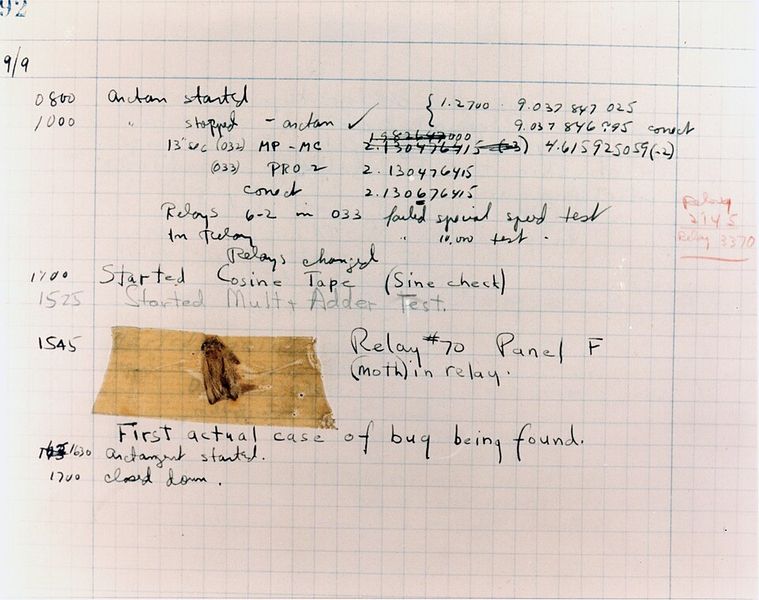
Страница из журнала с первым багом

В 1947 году операторы из команды Грейс Хоппер извлекли реального мотылька из реле компьютера Mark II. Хотя инженеры использовали слово «баг» (жук) для обозначения технических неполадок еще со времен Томаса Эдисона, это был первый задокументированный случай обнаружения буквального насекомого в вычислительной машине. Сегодня мы не ловим насекомых пинцетом, мы вычищаем логические галлюцинации из контекстных окон. И для этого нужен системный подход.

Анатомия ошибки: почему ИИ ломает рабочий код

Когда вы сталкиваетесь с ошибкой, важно понимать, что именно пошло не так. Нейросеть ошибается по трем основным причинам:

  1. Недостаток контекста. Вы попросили изменить Header.tsx, но забыли упомянуть, что данные в него передаются из Layout.tsx. ИИ делает предположение вслепую и ошибается.
  2. Устаревшие знания. Модель обучалась на React 17, а вы используете React 18, где некоторые хуки работают иначе (здесь спасают глобальные правила из .cursorrules, которые мы настроили ранее).
  3. Галлюцинация логики. Модель просто выбрала статистически вероятный, но логически неверный путь решения (например, использовала синхронный метод вместо асинхронного).

Чтобы исправить ошибку, нужно запустить правильный цикл обратной связи.

Правило №1: Не жалуйтесь, а предоставляйте улики

Худший промпт при отладке — это «не работает» или «выдает ошибку». Нейросеть не видит ваш экран и не умеет читать мысли. Услышав «не работает», ИИ начинает угадывать причину и часто переписывает совершенно здоровые куски кода, создавая новые проблемы.

Как правильно кормить ИИ ошибками:

  • Traceback (стек вызовов). Скопируйте весь красный текст из терминала или консоли браузера и отправьте ИИ. Если ошибка длинная, современные AI-native IDE (Cursor, Windsurf) позволяют выделить её в терминале и нажать Ctrl+L / Cmd+L, чтобы мгновенно добавить в контекст.
  • Симптом + Ожидание. Если технической ошибки нет, но логика сломана, опишите расхождение: «При вводе 'admin' в поле логина кнопка 'Войти' остается серой, хотя должна становиться активной».
  • Указание на подозреваемого. Если вы догадываетесь, где проблема, используйте точечные ссылки: «Посмотри на функцию валидации в @utils.ts, кажется, регулярное выражение пропускает пробелы».

Правило №2: Остерегайтесь загрязнения контекста

Это самая частая ловушка новичков. Вы отправляете ошибку, ИИ предлагает решение. Оно не работает. Вы отправляете новую ошибку. ИИ снова извиняется и пишет новый код.

После 4-5 таких итераций происходит загрязнение контекста.

Вспомните эффект Lost in the Middle. Контекстное окно чата теперь заполнено не вашими изначальными чистыми требованиями, а простынями неработающего кода, логами ошибок и извинениями нейросети. ИИ начинает опираться на свои же ошибочные решения из предыдущих сообщений, всё глубже закапываясь в неверную логику. Это называется «спираль галлюцинаций».

Как разорвать спираль галлюцинаций:

  1. Остановитесь. Если ИИ не смог решить проблему за 2-3 попытки, дальнейшие уговоры в том же чате только ухудшат ситуацию.
  2. Сделайте Откат (Revert). Отмените изменения в файле (Ctrl+Z или через систему контроля версий), вернув код к последнему рабочему состоянию. Не заставляйте ИИ «чинить то, что он только что сломал» — просто вернитесь в прошлое.
  3. Начните новый чат (Reset Context). Откройте новую сессию. Сформулируйте задачу заново, но теперь добавьте информацию о том, какой подход не сработал.

«Откат кода и старт нового чата — это не поражение, это очистка оперативной памяти вашего цифрового напарника».

Правило №3: Изоляция и «Метод резиновой уточки»

Если ошибка сложная, ИИ может не увидеть её даже в чистом контексте. В традиционном программировании разработчики используют «метод резиновой уточки» — объясняют код построчно неодушевленному предмету, чтобы найти логическую дыру. При вайбкодинге вы меняетесь ролями: вы заставляете ИИ стать вашей уточкой.

Попросите ИИ добавить логирование: «Я не понимаю, почему данные не доходят до компонента. Добавь console.log на каждом этапе трансформации данных в @DataProcessor.ts, чтобы мы могли отследить, где теряется объект».

Запустите код, соберите логи из консоли и отдайте их ИИ. Увидев реальные данные («Ага, на строке 45 массив становится undefined»), нейросеть моментально найдет ошибку, которую не видела при статичном анализе кода.

Роль человека: Diff-ревью

Вайбкодинг не освобождает вас от чтения кода. Когда ИИ предлагает исправление, AI-native IDE показывает вам Diff (разницу) — удаляемые строки подсвечиваются красным, добавляемые — зеленым.

Ваша задача как дирижера — перед тем как нажать Accept (Принять), задать себе три вопроса:

  1. Меняет ли ИИ только то, что нужно? (Если вы просили починить цвет кнопки, а ИИ переписывает логику работы с базой данных — отклоняйте Reject).
  2. Не удалил ли ИИ важные комментарии или импорты?
  3. Понятен ли вам этот код? Если ИИ написал нечитаемую «магию», попросите его: «Решение работает, но оно слишком сложное. Перепиши эту функцию проще, разбей на две понятные части».

Отладка в вайбкодинге — это танец. Вы направляете, ИИ генерирует, вы проверяете. Научившись быстро откатывать неудачные эксперименты и правильно скармливать логи, вы перестанете бояться красного текста в консоли. А когда локальная логика приложения отлажена и работает как часы, приходит время выходить во внешний мир.

Интеграция сторонних сервисов и API: расширение возможностей вашего приложения через ИИ

Интеграция сторонних сервисов и API: расширение возможностей вашего приложения через ИИ

Ваше приложение, созданное локально, похоже на гениального, но запертого в бункере ученого. Оно может идеально рассчитывать таймеры, управлять внутренним состоянием и красиво отрисовывать кнопки, но оно абсолютно слепо к внешнему миру. Оно не знает, какая сейчас погода в Токио, каков курс евро и прошел ли платеж от клиента. Чтобы приложение ожило, ему нужно научиться общаться с внешними системами через API (Application Programming Interface).

API — это цифровой контракт. Один сервис говорит: «Отправь мне данные в таком формате, и я верну тебе ответ в таком». Для вайбкодера интеграция API сводится к тому, чтобы правильно объяснить этот контракт нейросети. Но именно здесь кроется ловушка, в которую попадают 90% новичков.

Ловушка устаревших знаний (Knowledge Cutoff)

Когда вы просите ИИ: «Напиши код для получения курса валют через сервис X», модель обращается к своим внутренним весам — памяти, сформированной на момент ее обучения.

Если API сервиса обновилось месяц назад, нейросеть об этом не знает. Она уверенно сгенерирует код, опираясь на старую версию документации. Вы получите идеальный, логичный, красивый код, который при запуске выдаст ошибку 400 Bad Request или 404 Not Found. Это классическая логическая галлюцинация, механизм которой мы разбирали ранее.

Чтобы разорвать этот порочный круг, вайбкодер не должен полагаться на память модели. Вы должны стать курьером, который приносит ИИ самые свежие инструкции.

Внедрение документации (Doc Injection)

Вместо того чтобы спрашивать ИИ, как работает конкретный API, вы должны рассказать ему об этом. Этот подход называется внедрением документации.

Откройте официальную документацию нужного вам сервиса. Вам не нужно понимать каждую строчку, достаточно найти два элемента:

  1. Пример запроса (часто выглядит как команда curl или URL-адрес).
  2. Пример ответа (обычно это структура в формате JSON).

Скопируйте их и оберните во фреймворк CTCE. Вот как выглядит эволюция промпта от наивного к профессиональному.

Наивный промпт (обречен на провал):

Добавь на дашборд виджет погоды через OpenWeatherMap.

Инженерный промпт (Doc Injection):

Контекст: Мы создаем виджет погоды для дашборда. Задача: Напиши функцию для получения текущей температуры по координатам. Ограничения: Используй fetch. Обработай возможные ошибки сети. Примеры (Документация API): URL для запроса: https://api.openweathermap.org/data/2.5/weather?lat={lat}&lon={lon}&appid={API key} Ожидаемый ответ от сервера: { "main": { "temp": 298.48, "humidity": 64 }, "name": "London" } Извлеки из ответа только поле temp и name.

Предоставив точный пример JSON-ответа, вы гарантируете, что ИИ напишет правильный путь к данным (например, data.main.temp), даже если он никогда раньше не видел этот API.

Безопасность: граница переменных окружения

Любой платный или лимитированный API требует ключ доступа (API Key) — ваш уникальный пароль.

Если вы просто вставите свой ключ в промпт, ИИ услужливо зашьет его прямо в исходный код вашего приложения (например, в файл widget.js). Если вы опубликуете такой код в открытом доступе, ваш ключ украдут боты за считанные секунды, что может привести к блокировке аккаунта или финансовым потерям.

Вайбкодер должен жестко контролировать границу безопасности. Ключи никогда не хранятся в коде. Они хранятся в специальном локальном файле .env (environment variables), который игнорируется при публикации.

Правильная инструкция для ИИ звучит так:

«Создай запрос к API. Ключ доступа бери из переменной окружения WEATHER_API_KEY. Не хардкодь ключ в коде. Напиши мне инструкцию, что я должен добавить в свой локальный файл .env».

Анатомия асинхронности: время ожидания

Когда ваше локальное приложение вызывает локальную функцию, результат возвращается мгновенно. Когда приложение обращается к серверу на другом континенте, возникает задержка. Физику обмануть нельзя: сигнал должен пройти по кабелям, сервер должен обработать запрос и вернуть ответ. Это время обозначается как Δt>0\Delta t > 0. Здесь Δt\Delta t (дельта тэ) — это время задержки в сети (разница во времени между отправкой запроса и получением ответа). Например, если вы нажали кнопку «Узнать погоду», а сервер OpenWeatherMap прислал данные через 2 секунды, то Δt=2\Delta t = 2 секунды.

Если не учесть это время, приложение «зависнет», ожидая ответа. В современном программировании эта проблема решается концепцией асинхронности (async/await). Для вайбкодера технические детали реализации вторичны, но критически важно понимать состояния интерфейса, которые порождает эта задержка.

Любой сетевой запрос разбивает ваш интерфейс на три возможных состояния:

  1. Загрузка (Loading): Запрос отправлен, ответа еще нет. Пользователь должен видеть спиннер или скелетон, иначе он решит, что кнопка не сработала, и нажмет ее еще десять раз.
  2. Успех (Success): Данные получены, мы отображаем результат.
  3. Ошибка (Error): Сервер упал, пропал интернет или кончились деньги на API-ключе. Пользователь должен увидеть понятное сообщение, а не пустой экран.

Когда вы ставите ИИ задачу на интеграцию API, недостаточно попросить «получи данные». Вымечайте требования так:

«Реализуй компонент конвертера валют. Пока идет запрос к API, показывай текст "Обновляем курс...". Если запрос завершился ошибкой, покажи красную плашку "Не удалось загрузить актуальный курс" и кнопку "Повторить". Только при успешном ответе показывай финальную сумму».

Заставляя ИИ явно прописывать состояния загрузки и ошибки, вы превращаете хрупкий лабораторный скрипт в надежный продукт, готовый к встрече с реальными пользователями и нестабильным мобильным интернетом.

Интеграция API — это мост между вашим локальным кодом и всем интернетом. Научившись внедрять документацию и управлять асинхронными состояниями, вы снимаете любые ограничения с того, что может делать ваше приложение. Однако, когда таких интеграций становится много — база данных, платежи, рассылки — код начинает запутываться. Чтобы проект не рухнул под собственным весом, нам потребуется системный подход к проектированию, к которому мы и перейдем на следующем этапе.

Архитектурное мышление вайбкодера: проектирование логики без ручного написания функций

Архитектурное мышление вайбкодера: проектирование логики без ручного написания функций

Если нейросеть способна написать 100 строк безупречного кода за 5 секунд, логично предположить, что создание приложения на 10 000 строк займет около 8 минут. На практике эта математика не работает. Попытка скормить ИИ масштабную идею целиком приводит к созданию цифрового «франкенштейна»: функции дублируются, данные теряются, а малейшее изменение ломает всю систему. Когда вы перестаете писать функции вручную, ваша главная задача кардинально меняется. Вы больше не укладываете кирпичи — вы проектируете несущие конструкции.

Ловушка монолита и комбинаторный взрыв

Представьте, что вы просите ИИ: «Напиши мне систему управления задачами с календарем, уведомлениями и интеграцией почты». Модель начнет генерировать код, смешивая в одном файле отрисовку кнопок, логику расчета дат и сетевые запросы.

Проблема кроется в количестве связей. Если в приложении есть NN логических блоков, то количество возможных неконтролируемых связей между ними описывается формулой:

C=N(N1)2C = \frac{N(N-1)}{2}

Где CC — количество связей, а NN — число компонентов.

Если у вас 3 компонента (интерфейс, база данных, уведомления), связей всего 3. Но если компонентов 10, количество связей прыгает до 45. Контекстное окно переполняется противоречивыми инструкциями, начинается «спираль галлюцинаций», и модель теряет нить архитектуры.

Чтобы избежать этого, вайбкодер использует декомпозицию — разделение системы на независимые слои, которые общаются друг с другом по строгим правилам.

Три кита архитектуры: Интерфейс, Логика, Данные

Разделение ответственности (Separation of Concerns) — это принцип, при котором каждый модуль занимается только одной задачей. При работе с ИИ это не просто правило хорошего тона, а единственный способ получить рабочий результат.

Мы делим приложение на три независимых слоя:

  1. Слой данных (Data). Отвечает за общение с внешним миром. Именно здесь живут интеграции с API, переменные окружения и обработка сетевых ошибок. Этот слой ничего не знает о том, как выглядят кнопки.
  2. Бизнес-логика (Logic). Мозг приложения. Здесь происходят вычисления, валидация, расчет скидок или фильтрация списков. Этот слой получает сырые данные и превращает их в полезную информацию.
  3. Интерфейс (UI). Глупый, но красивый слой. Его единственная задача — отобразить то, что передала логика, и поймать клик пользователя.

Когда вы формулируете задачу через фреймворк CTCE, вы должны четко понимать, в каком слое находитесь. Выпрашивая у ИИ компонент карточки товара, вы запрещаете ему делать запрос к базе данных внутри этой карточки. Вы просите: «Создай UI-компонент, который ожидает получить готовые данные о товаре».

Единый источник истины (Single Source of Truth)

Когда приложение разбито на десятки мелких компонентов, возникает новая проблема: как они обмениваются информацией?

Допустим, пользователь добавляет товар в корзину. Иконка корзины в шапке сайта должна обновить счетчик, кнопка «Купить» должна поменять цвет, а панель рекомендаций — предложить сопутствующие товары. Если кнопка начнет напрямую посылать сигналы шапке и панели рекомендаций, мы снова получим хаос из формулы C=N(N1)2C = \frac{N(N-1)}{2}.

Архитектурное решение этой проблемы — Состояние (State).

Состояние — это специальное хранилище данных, которое является «единым источником истины» для всего приложения. Компоненты не общаются друг с другом напрямую. Они общаются только с Состоянием.

  1. Кнопка сообщает Состоянию: «Пользователь купил товар X».
  2. Состояние обновляет свои внутренние данные.
  3. Состояние автоматически рассылает новые данные всем компонентам, которые на него подписаны (шапке, панели рекомендаций).

Архитектура — это решения, которые трудно изменить впоследствии.

Мартин Фаулер, автор книг по проектированию ПО

Вайбкодер проектирует структуру данных до того, как просит ИИ рисовать интерфейс. Вы описываете модели данных: «У нас будет объект пользователя с полями имя, статус подписки и баланс». И только потом поручаете модели: «Сгенерируй компонент профиля, который принимает объект пользователя и отрисовывает его».

Проектирование через контракты (Interface-First)

Секрет успешной сборки сложного приложения чужими (искусственными) руками — это контракты. Контракт — это жесткая договоренность о том, какие данные функция принимает на вход и что отдает на выходе.

Вместо того чтобы заставлять ИИ писать весь модуль аналитики, вы сначала просите: «Напиши только структуру (интерфейс) для функции расчета метрик. Она должна принимать массив объектов продаж и возвращать общую выручку и средний чек. Саму логику пока не пиши, просто верни заглушки».

Получив такой контракт, вы можете параллельно:

  • Поручить ИИ создать интерфейс дашборда, который использует эти заглушки.
  • Поручить ИИ написать логику расчета, которая соответствует этому контракту.

Архитектурное мышление освобождает вас от синтаксиса. Вы не думаете о том, как написать цикл фильтрации. Вы думаете о том, как данные перетекают от сервера к состоянию, а от состояния — к кнопке на экране пользователя. Когда каркас приложения выстроен, логика изолирована, а данные текут в одном направлении, остается последний шаг — выпустить этот продукт в реальный мир.

Финальная сборка и деплой: как превратить сгенерированный код в работающий продукт

Финальная сборка и деплой: как превратить сгенерированный код в работающий продукт

Ваше приложение работает. Архитектурные слои общаются без ошибок, API-запросы возвращают нужные данные, а интерфейс мгновенно реагирует на действия пользователя. Но есть один нюанс: прямо сейчас весь этот триумф существует только по адресу localhost:3000. Если вы закроете крышку ноутбука, приложение исчезнет.

Вайбкодинг не заканчивается на генерации логики. Истинная цель — передать ценность пользователям. В этой главе мы разберем, как код покидает вашу локальную машину, проходит этап трансформации и оказывается на серверах, доступный всему миру.

От песочницы к реальному миру: зачем нужна сборка

Когда вы разрабатываете приложение в Cursor или Windsurf, вы находитесь в режиме Development (разработка). В этом режиме инструменты отдают приоритет вашему удобству: код не сжат (чтобы ИИ и вы могли его читать), ошибки выводятся с подробными подсказками, а каждое сохранение файла мгновенно обновляет страницу.

Но для реальных пользователей (режим Production) эти удобства становятся критической уязвимостью и тормозом. Подробные логи ошибок могут выдать хакерам структуру вашей базы данных, а несжатый код заставит пользователей мобильного интернета ждать загрузки десятки секунд.

Поэтому перед тем, как отправить приложение в сеть, оно должно пройти процесс сборки (Build).

Сборка решает две главные физические проблемы передачи данных через интернет. Математически время загрузки страницы можно описать упрощенной формулой:

T=Sv+N×PT = \frac{S}{v} + N \times P

Где TT — общее время загрузки, SS — суммарный объем файлов, vv — скорость интернета пользователя, NN — количество запрашиваемых файлов, а PP — пинг (задержка соединения на установку каждого отдельного запроса).

Пример: Допустим, суммарный объем файлов вашего приложения S=2000S = 2000 КБ, скорость мобильного интернета v=1000v = 1000 КБ/с, количество файлов N=100N = 100, а пинг P=0.05P = 0.05 секунды (50 мс). Тогда общее время загрузки составит T=20001000+100×0.05=2+5=7T = \frac{2000}{1000} + 100 \times 0.05 = 2 + 5 = 7 секунд. Если благодаря процессу сборки мы сократим количество файлов NN до 5, время загрузки радикально упадет до 2+5×0.05=2.252 + 5 \times 0.05 = 2.25 секунд.

Мы не можем повлиять на скорость интернета vv или пинг PP пользователя. Наша задача — минимизировать SS и NN. Для этого процесс сборки делает два шага:

  1. Бандлинг (Bundling): Склеивает сотни мелких компонентов, которые мы спроектировали для удобства архитектуры, в один или несколько крупных файлов. Это резко снижает параметр NN. Браузеру гораздо быстрее скачать один файл на 500 КБ, чем 100 файлов по 5 КБ, так как не тратится время на установку 100 отдельных соединений.
  2. Минификация (Minification): Удаляет из кода все пробелы, переносы строк, комментарии и переименовывает длинные переменные (например, userProfileData превращается в a). Это радикально снижает размер файлов SS.

Сборка — это перевод приложения с человеческого языка (понятного вам и LLM) на язык максимальной производительности, понятный только машинам.

Деплой и магия CI/CD

Деплой (Deploy) — это процесс доставки собранного приложения на сервер, откуда оно будет доступно по публичному URL-адресу.

В прошлом деплой был рутинной и опасной задачей: разработчики вручную собирали файлы на своем компьютере, подключались к серверу через FTP и копировали файлы, молясь, чтобы ничего не сломалось. Сегодня в мире вайбкодинга балом правит подход CI/CD (Continuous Integration / Continuous Deployment — непрерывная интеграция и доставка).

Вам больше не нужно настраивать серверы. Существуют платформы вроде Vercel, Netlify или Cloudflare Pages, которые берут всю инфраструктуру на себя. Они работают в связке с GitHub по следующему сценарию:

  1. Вы просите ИИ зафиксировать изменения и отправить код в ваш репозиторий на GitHub (сделать Push).
  2. Платформа хостинга (например, Vercel) мгновенно замечает, что в GitHub появился новый код.
  3. Сервер Vercel скачивает ваш код, самостоятельно запускает процесс сборки (npm run build).
  4. Если сборка прошла успешно, Vercel подменяет старую версию сайта на новую.

Этот процесс означает, что вайбкодеру вообще не нужно касаться серверных настроек. Ваша единственная задача — убедиться, что код работает локально, и отправить его в GitHub. Всю остальную цепочку платформа выполнит автоматически за пару минут.

Секреты вне дома: переменные окружения в Production

В главе про интеграцию API мы обсуждали, что ключи от сторонних сервисов (например, от платежного шлюза или базы данных) хранятся в файле .env. Главное правило безопасности гласило: файл .env никогда не отправляется в GitHub. Он остается только на вашем локальном компьютере.

Но здесь возникает парадокс. Если Vercel скачивает ваш код из GitHub, а файла .env там нет, как собранное приложение на сервере получит доступ к API?

Ответ кроется в настройках самой платформы хостинга. В панелях управления Vercel или Netlify есть специальный раздел — Environment Variables (Переменные окружения).

Вы должны вручную скопировать значения из вашего локального файла .env и вставить их в настройки проекта на платформе хостинга. Во время автоматической сборки (шаг 3 из CI/CD пайплайна) сервер заботливо подставит эти переменные в нужные места кода.

Чек-лист вайбкодера перед релизом

Вайбкодинг позволяет двигаться очень быстро, но перед деплоем важно замедлиться и провести финальную проверку. Вот как выглядит идеальный диалог с ИИ перед релизом:

  1. Проверка сборки локально. Прежде чем отправлять код в сеть, попросите ИИ: "Запусти локальную сборку и проверь, нет ли ошибок типизации или неиспользуемых переменных". Лучше поймать ошибку бандлинга у себя, чем получить упавший деплой на сервере.
  2. Аудит консоли. Напишите промпт: "Проверь все компоненты и удали лишние console.log, которые мы использовали для отладки".
  3. Фиксация состояния. "Сделай коммит с сообщением 'Подготовка к релизу: настроено API и стейт' и отправь в ветку main".

Как только код улетел в репозиторий, абстрактная концепция, которую вы описывали текстом несколько часов назад, обретает физический адрес в интернете. Вы больше не просто пишете промпты — вы поставляете готовый продукт.

Мы прошли путь от идеи до работающего и опубликованного приложения. В заключительной главе мы поднимемся над техническими деталями и посмотрим на картину в целом: как эти навыки меняют рынок труда и как развиваться в профессии, где рутинное написание кода окончательно делегировано машинам.

Будущее профессии: как развиваться в мире, где код пишет машина

Будущее профессии: как развиваться в мире, где код пишет машина

В предыдущей главе мы успешно собрали наш проект и отправили его на сервер — теперь им могут пользоваться люди по всему миру. Весь этот путь, от пустой папки до работающего продукта, мы прошли, делегируя написание строк кода искусственному интеллекту. И здесь возникает закономерный, немного пугающий вопрос: если машина способна за секунды генерировать, отлаживать и собирать сложные приложения, зачем в этом процессе нужен человек? Не приведет ли вайбкодинг к исчезновению профессии разработчика?

Чтобы заглянуть в будущее, нам нужно посмотреть в прошлое.

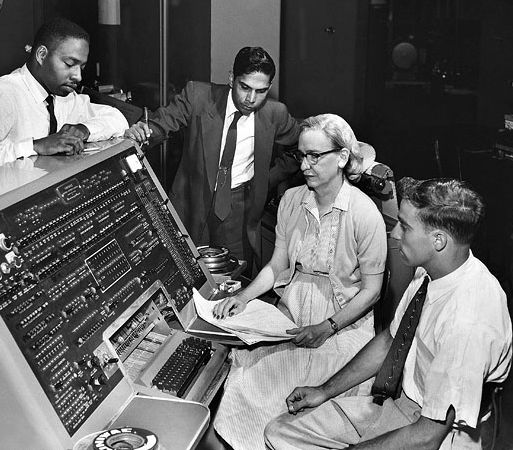
В начале 1950-х годов программирование выглядело как переключение физических тумблеров или написание машинных кодов — бесконечных рядов нулей и единиц. Когда выдающаяся ученая Грейс Хоппер создала первый в истории компилятор (программу, переводящую математические символы, а позднее — и понятные человеку английские слова, в машинный код), многие «настоящие» программисты возмутились. Им казалось, что автоматизация написания машинных команд убьет их ремесло.

Портрет Грейс Хоппер за работой

«Мне говорили, что компьютеры могут только считать, а не писать программы. Никто не верил в компилятор».

Грейс Хоппер, пионер программирования

На деле произошло обратное: абстрагировавшись от нулей и единиц, люди смогли создавать гораздо более сложные системы. Профессия не исчезла — она масштабировалась. Сегодня вайбкодинг делает с традиционным программированием ровно то же самое, что компиляторы сделали с машинными кодами.

Экономика вайбкодинга: Парадокс Джевонса

Первая мысль при виде того, как ИИ пишет код в десять раз быстрее человека: «Значит, компаниям теперь нужно в десять раз меньше программистов». Это логика линейного мышления. Но экономика технологий работает иначе — она подчиняется правилу, известному как парадокс Джевонса.

В XIX веке экономист Уильям Стэнли Джевонс заметил странную вещь: когда паровые двигатели стали более эффективными и начали потреблять меньше угля, общее потребление угля в Англии не упало, а резко выросло. Почему? Потому что дешевая энергия привела к взрывному росту числа новых фабрик и машин. Удешевление ресурса многократно увеличивает спрос на него.

В разработке программного обеспечения ресурсом является код.

Пусть C — это стоимость создания одной функции (в часах или деньгах), а D — общий спрос на программное обеспечение в мире. До появления ИИ стоимость C была огромной: чтобы автоматизировать документооборот в маленькой пекарне, нужно было нанимать команду инженеров за десятки тысяч долларов. Поэтому спрос D ограничивался только самыми прибыльными сферами (банки, крупные корпорации, массовые сервисы).

С приходом вайбкодинга стоимость C стремится к минимуму. Что произойдет со спросом D? Он улетит в космос.

Миру нужно бесконечное количество программного обеспечения. Каждой школе нужна своя система расписания, каждому локальному бизнесу — своя CRM, каждому ученому — скрипт для анализа его специфических данных. Раньше это было экономически невыгодно. Теперь, когда ИИ снизил барьер входа, мы увидим взрывной рост количества создаваемых приложений. И для каждого из них нужен человек, который придумает концепцию, опишет бизнес-логику и проконтролирует результат.

От наборщика текста к инженеру продукта

Вайбкодинг не отменяет инженерию, он меняет ее фокус. Если раньше разработчик тратил 80% времени на синтаксис (где поставить скобку, как правильно вызвать метод библиотеки) и 20% на решение бизнес-задачи, то теперь эта пропорция переворачивается.

Ценность специалиста больше не измеряется знанием наизусть документации Next.js или умением быстро печатать алгоритмы сортировки. На первый план выходит роль Product Engineer (продуктового инженера) — человека, который понимает, зачем мы пишем код, и умеет оркестрировать работу ИИ для достижения этой цели.

Чтобы оставаться востребованным и успешно развиваться в мире вайбкодинга, вам нужно прокачивать три фундаментальных навыка:

1. Системное мышление и архитектура

ИИ отлично пишет локальные функции, но он (пока) не умеет придумывать глобальную архитектуру с нуля без вашей помощи. Как мы разбирали ранее, проблема комбинаторного взрыва связей никуда не исчезла. Вам необходимо понимать:

  • Как данные перетекают из базы данных в интерфейс.
  • Где должен лежать единый источник истины (State).
  • Как правильно разделить монолит на независимые слои (декомпозиция).

2. Доменная экспертиза (понимание предметной области)

Нейросеть знает все языки программирования, но она ничего не знает о специфике вашего бизнеса. Если вы создаете приложение для логистики, ваша ценность — в знании того, как работают склады, какие бывают габариты грузов и почему водителям неудобно нажимать мелкие кнопки в интерфейсе. ИИ напишет код корзины, но именно вы должны сказать ему: «В нашем магазине товары со сроком годности меньше суток нельзя добавлять в доставку на завтра».

3. Навык верификации и ревью

Как мы помним из главы про спираль галлюцинаций, ИИ неизбежно ошибается. Ваш главный рабочий инструмент — это критическое мышление. Вы становитесь старшим инженером, который проверяет работу невероятно быстрого, но иногда невнимательного стажера. Умение читать Diff-ревью, анализировать логи и находить логические нестыковки становится важнее умения писать код с нуля.

Как учиться технологиям сегодня?

Если вы хотите освоить программирование с нуля прямо сейчас, ваш путь должен радикально отличаться от того, как учились люди пять лет назад.

Подход прошлого (Ручной кодинг) Подход будущего (Вайбкодинг)
Заучивание синтаксиса языка (циклы, классы, массивы). Изучение концепций (что такое цикл, зачем нужны классы, как работают структуры данных).
Написание сотен строк кода по туториалам для мышечной памяти. Практика промпт-инжиниринга: формулирование задач через фреймворк CTCE.
Изучение конкретных библиотек (например, как сделать запрос через axios). Изучение фундаментальных протоколов (как работает HTTP, что такое API, статусы ответов).
Поиск готовых решений на StackOverflow. Итеративный диалог с AI-native IDE (Cursor, Windsurf) для генерации уникального решения.

Ваша задача — стать Т-образным специалистом нового типа. Горизонтальная перекладина буквы «Т» — это широкий кругозор: понимание того, как работают сети, базы данных, интерфейсы и бизнес-процессы. Вертикальная черта — это глубокое владение инструментами вайбкодинга (управление контекстным окном, внедрение документации, отладка галлюцинаций).

«Будущее принадлежит тем, кто умеет задавать правильные вопросы, а не тем, кто знает все ответы».

— негласное правило эпохи ИИ.

Заключение курса

Мы прошли большой путь. От осознания того, что код теперь — это не текст на экране, а семантический смысл, который мы передаем машине. Мы заглянули под капот нейросетей, научились формулировать инженерные промпты, управлять вниманием ИИ через воронку контекста, бороться с галлюцинациями и выстраивать архитектуру через контракты.

Вайбкодинг — это не просто новый инструмент. Это смена парадигмы. Вы больше не наборщик текста, который переводит человеческие мысли на язык, понятный процессору. Процессор (через LLM) выучил человеческий язык.

Теперь вы — дирижер. Перед вами огромный оркестр из нейросетей, готовый сыграть любую симфонию. Ваша задача — написать партитуру, задать темп и, самое главное, услышать ту самую фальшивую ноту, чтобы вовремя ее исправить.

Мир ждет ваших идей. Открывайте Cursor, создавайте новый проект и начинайте творить.