Комбинаторика с нуля: фундамент для теории вероятностей и Data Science

Практический курс знакомит с фундаментальными принципами комбинаторики с самых азов, формируя необходимую математическую базу для понимания теории вероятностей, статистики и анализа данных. Вы последовательно освоите ключевые правила подсчета, перестановки, сочетания и размещения, научившись уверенно решать задачи без зубрежки формул. Особый фокус сделан на развитии комбинаторного мышления и разборе прикладных примеров, лежащих в основе вероятностных моделей.

Правила сложения и умножения

Правила сложения и умножения

Представьте, что вы проектируете систему авторизации. Четырехзначный PIN-код из цифр от 0 до 9 взламывается простым перебором за пару секунд: в нем ровно 10 000 вариантов. Но если потребовать добавить хотя бы одну букву латинского алфавита, число комбинаций взлетит до сотен тысяч. Почему добавление одного символа меняет безопасность системы в десятки раз? И как дата-сайентисту быстро оценить, сколько конфигураций придется перебрать алгоритму GridSearchCV при подборе гиперпараметров модели машинного обучения?

В основе комбинаторики, теории вероятностей и всей вычислительной математики лежат всего два фундаментальных принципа: правило сложения и правило умножения. Они позволяют отвечать на главный вопрос комбинаторики: «Сколькими способами можно получить нужный результат?», не выписывая все варианты вручную.


Правило сложения: выбор по принципу «ИЛИ»

Начнем с базовой ситуации: перед нами несколько групп вариантов, и нам нужно выбрать ровно один вариант из всех возможных.

Правило сложения: Если объект AA можно выбрать mm способами, а объект BBnn способами, причем выбор AA и выбор BB исключают друг друга (не могут произойти одновременно), то выбрать «либо AA, либо BB» можно m+nm + n способами.

Математически для любого количества непересекающихся групп вариантов kk:

N=n1+n2++nkN = n_1 + n_2 + \dots + n_k

Здесь:

  • NN — общее число способов сделать единственный выбор;
  • n1,n2,,nkn_1, n_2, \dots, n_k — количество вариантов выбора в каждой отдельной независимой категории.

Практический пример: Аналитик данных решает задачу классификации текстов. У него есть выбор: использовать одну из 3 моделей на основе решающих деревьев (Random Forest, Gradient Boosting, Extra Trees) или одну из 2 линейных моделей (логистическая регрессия, линейный SVM). Аналитик намерен запустить в качестве базового решения ровно одну модель. Сколькими способами он может выбрать алгоритм?

Поскольку модель выбирается только одна, варианты не пересекаются: 3+2=53 + 2 = 5 способов.

Критическое условие: несовместность

Сложение работает только тогда, когда варианты не пересекаются. В теории множеств это означает, что множества вариантов не имеют общих элементов: их пересечение пусто (AB=A \cap B = \emptyset).

Если варианты могут совпасть, простое сложение приведет к дублированию. Например, если среди 10 сотрудников 6 владеют Python, а 5 — SQL, мы не можем сложить 6+5=116 + 5 = 11, если кто-то знает оба инструмента. Подсчет объектов с пересечениями регулируется принципом включений-исключений, который подробно разобран в главе 6. В рамках правила сложения мы всегда следим за тем, чтобы категории были взаимоисключающими.


Правило умножения: цепочка выбора по принципу «И»

Теперь усложним задачу: вместо выбора одного объекта из альтернатив нам нужно сконструировать составной объект, совершив серию последовательных шагов: выбрать первый элемент И второй элемент И третий элемент.

Правило умножения: Если первый шаг можно выполнить mm способами, а после каждого такого выбора второй шаг можно выполнить nn способами, то последовательность из двух шагов можно выполнить m×nm \times n способами.

В общем виде для цепочки из kk последовательных шагов:

N=n1×n2××nkN = n_1 \times n_2 \times \dots \times n_k

Здесь:

  • NN — общее число итоговых комбинаций;
  • n1n_1 — количество вариантов на первом шаге;
  • n2n_2 — количество вариантов на втором шаге (при любом исходе первого шага);
  • nkn_k — количество вариантов на kk-м шаге.

Практический пример: Вы настраиваете архитектуру полносвязной нейронной сети для классификации табличных данных. Вам нужно выбрать:

  1. Функцию активации на скрытых слоях: ReLU, GELU или Swish (3 варианта).
  2. Оптимизатор: AdamW или SGD (2 варианта).
  3. Размер батча: 32, 64, 128 или 256 (4 варианта).

Каждый вариант первого шага свободно комбинируется с любым вариантом второго и третьего. Общее число уникальных архитектур для эксперимента:

N=3×2×4=24N = 3 \times 2 \times 4 = 24

Получаем 24 уникальные конфигурации.

Дерево исходов: как увидеть правило умножения

Чтобы понять, почему варианты именно перемножаются, полезно представить процесс в виде дерева решений (графа). Корень дерева — исходное состояние. Из него выходят ветви первого шага, из конца каждой ветви — ветви второго шага, и так далее.

Каждый путь от корня до финального листа дерева представляет собой одну законченную комбинацию.

Как видно на схеме, если на первом уровне образуется 3 ветки, и из каждой выходит по 2 новые ветки, общее количество листьев на конце дерева равно 3×2=63 \times 2 = 6. Умножение — это компактная запись разветвления дерева.

Инвариантность количества, а не состава

Одно из самых частых заблуждений в правиле умножения: начинающие думают, что на каждом шаге должны быть доступны одни и те же объекты. Это не так.

Важно лишь то, чтобы количество вариантов на следующем шаге оставалось неизменным, независимо от того, какой именно объект был выбран на предыдущем шаге.

Пример: В отделе из 5 аналитиков нужно назначить тимлида и код-ревьюера. Тимлидом может стать любой из 5 человек. После того как тимлид назначен, код-ревьюером можно назначить любого из оставшихся сотрудников. Сам состав кандидатов на втором шаге меняется (выбранный тимлид уже не доступен), но их количество всегда строго равно 51=45 - 1 = 4. Значит, правило умножения законно:

N=5×4=20 способовN = 5 \times 4 = 20 \text{ способов}


Сравнение правил: ИЛИ против И

Чтобы не путать эти правила на практике, сведем их ключевые отличия в таблицу:

Критерий Правило сложения Правило умножения
Логическая связка «ИЛИ» (выбор альтернативы) «И» (последовательный выбор)
Характер действия Выбирается один элемент из множества групп Формируется кортеж/набор из элементов разных групп
Графическая модель Объединение параллельных путей Последовательное ветвление (дерево исходов)
Ключевое требование Несовместность вариантов (нет общих исходов) Независимость числа вариантов на каждом шаге
Формула N=n1+n2++nkN = n_1 + n_2 + \dots + n_k N=n1×n2××nkN = n_1 \times n_2 \times \dots \times n_k

Комбинирование правил в реальных задачах

В реальных инженерных и аналитических задачах сложение и умножение почти всегда работают в тандеме. Разберем сквозной сценарий.

Кейс: генерация идентификаторов для Data Pipeline

Инженер данных проектирует схему генерации временных токенов сессий для API. Токен формируется по следующему регламенту:

  • Токен состоит из двух частей: буквенного префикса и числового суффикса.
  • Префикс указывает на тип среды: либо односимвольный для тестов ('T'), либо двухсимвольный для продакшена (две заглавные буквы латинского алфавита от 'A' до 'Z', всего 26 букв).
  • Суффикс — это последовательность из трех цифр (от 0 до 9), причем первая цифра суффикса не может быть нулем (доступны цифры от 1 до 9).

Сколько всего уникальных токенов можно сгенерировать по такой спецификации?

Разобьем решение на логические уровни:

  1. Шаг 1. Анализ префикса (правило сложения + правило умножения): Префикс бывает либо тестовым, либо продакшен:

    • Тестовый префикс: ровно 1 вариант ('T').
    • Продакшен-префикс: первая буква (26 вариантов) И вторая буква (26 вариантов). По правилу умножения: 26×26=67626 \times 26 = 676 вариантов.
    • Поскольку среда может быть либо тестовой, либо продакшен (несовместные события), применяем правило сложения:

    Nprefix=1+676=677 вариантов префиксаN_{\text{prefix}} = 1 + 676 = 677 \text{ вариантов префикса}

  2. Шаг 2. Анализ числового суффикса (правило умножения): Суффикс состоит из трех цифр:

    • Первая цифра (от 1 до 9): 9 вариантов.
    • Вторая цифра (от 0 до 9): 10 вариантов.
    • Третья цифра (от 0 до 9): 10 вариантов.

    По правилу умножения для трех позиций:

    Nsuffix=9×10×10=900 вариантов суффиксаN_{\text{suffix}} = 9 \times 10 \times 10 = 900 \text{ вариантов суффикса}

  3. Шаг 3. Итоговая сборка токена: Токен состоит из префикса И суффикса. Связка «И» означает финальное применение правила умножения:

    Ntotal=Nprefix×Nsuffix=677×900=609300N_{\text{total}} = N_{\text{prefix}} \times N_{\text{suffix}} = 677 \times 900 = 609\,300

Мы получили более 600 тысяч уникальных идентификаторов, разложив сложный регламент на элементарные шаги сложения и умножения.


Связь с теорией вероятностей и Data Science

Зачем эти формулы специалисту по анализу данных?

В классической теории вероятностей вероятность любого случайного события AA вычисляется по формуле:

P(A)=mNP(A) = \frac{m}{N}

Где:

  • P(A)P(A) — вероятность наступления события AA;
  • mm — число благоприятных исходов;
  • NN — общее число всех возможных элементарных исходов в пространстве событий.

Например, вероятность того, что сгенерированный в нашем примере токен случайно окажется тестовым, равна отношению числа тестовых токенов (1×900=9001 \times 900 = 900) ко всем возможным токенам (609300609\,300):

P(Test)=9006093000,00147 (около 0,15%)P(\text{Test}) = \frac{900}{609\,300} \approx 0{,}00147 \text{ (около } 0{,}15\%)

Без умения строго подсчитать NN и mm с помощью правил суммы и произведения невозможно найти ни одну вероятность в дискретном пространстве.

Кроме того, правило умножения лежит в основе проблемы комбинаторного взрыва при подборе гиперпараметров (Grid Search). Если у вас есть 6 параметров, и для каждого вы проверяете всего по 5 значений, алгоритм должен обучить и протестировать модель:

5×5×5×5×5×5=56=15625 раз5 \times 5 \times 5 \times 5 \times 5 \times 5 = 5^6 = 15\,625 \text{ раз}

Если одно обучение занимает хотя бы 10 секунд, полный перебор продлится более 43 часов. Понимание правил комбинаторики позволяет вовремя заметить взрывной рост вычислений и перейти к более эффективным методам — например, случайному поиску (Random Search) или байесовской оптимизации.

Итак, мы выяснили: выбор одной альтернативы из непересекающихся групп требует сложения («ИЛИ»), а построение цепочки независимых выборов — умножения («И»). Но что делать, если мы выбираем элементы из одного и того же множества, причем порядок выбора имеет значение или элементы начинают перемешиваться между собой? Об этом пойдет речь в следующей статье, посвященной факториалу и перестановкам.
Факториал и перестановки

Факториал и перестановки

Если вы тщательно перетасуете стандартную колоду из 52 карт, то с вероятностью, практически неотличимой от единицы, полученная последовательность карт никогда раньше не возникала за всю историю человечества. Более того, она вряд ли повторится до тех пор, пока существует Вселенная. Число возможных порядков колоды равно 52!52! — это число из 68 знаков (8,0658×10678{,}0658 \times 10^{67}), которое лишь ненамного уступает оценочному количеству атомов во всей видимой части космоса.

Каким образом простая операция выстраивания объектов в цепочку порождает столь невообразимые пространства вариантов? Ответ вытекает непосредственно из логики последовательного выбора.

От цепочки независимых выборов к перестановкам

В задачах последовательного выбора мы перемножаем количество альтернатив на каждом шаге, если число доступных ветвей на следующем этапе не зависит от того, что именно мы выбрали на предыдущем.

Представьте конвейер подготовки признаков (Data Preprocessing Pipeline), состоящий из nn изолированных шагов: например, стандартизация значений, заполнение пропусков, кодирование категорий и удаление выбросов. Мы хотим применить все nn шагов, но порядок их выполнения пока произволен. Сколькими способами можно организовать этот конвейер?

Разобьем процесс на nn последовательных позиций («слотов»):

  1. Первый слот конвейера: у нас есть выбор из всех nn имеющихся операций.
  2. Второй слот: одна операция уже задействована на первом шаге. Независимо от того, какая именно это была операция, неиспользованными остаются ровно n1n - 1 вариантов.
  3. Третий слот: две операции уже заняты, на выбор остается n2n - 2 шага.
  4. Последний (nn-й) слот: все операции, кроме одной, уже распределены. Для финальной позиции остается единственный кандидат (1 вариант).

По правилу умножения общее количество способов собрать такой конвейер равно произведению вариантов на каждом шаге:

Pn=n×(n1)×(n2)××2×1P_n = n \times (n - 1) \times (n - 2) \times \dots \times 2 \times 1

В этой формуле:

  • PnP_n — число перестановок множества из nn элементов (от латинского permutatio — перемещение, перестановка).
  • nn — количество кандидатов на первую позицию.
  • (n1),(n2),,1(n - 1), (n - 2), \dots, 1 — остаток кандидатов на каждом последующем шаге, уменьшающийся строго на единицу.

Перестановка без повторений из nn элементов — это любое упорядоченное расположение всех элементов множества длины nn, где каждый исходный объект встречается ровно один раз.

Для конвейера из 4 шагов число альтернативных порядков равно P4=4×3×2×1=24P_4 = 4 \times 3 \times 2 \times 1 = 24. Если конвейер расширится всего до 7 этапов, число маршрутов возрастет до P7=7×6×5×4×3×2×1=5040P_7 = 7 \times 6 \times 5 \times 4 \times 3 \times 2 \times 1 = 5040.

Анатомия факториала и парадокс пустого множества

Произведение всех натуральных чисел от 1 до nn обозначается символом n!n! (читается «эн факториал»). Это компактная запись длины пространства всех возможных упорядочиваний:

n!=k=1nk=1×2××nn! = \prod_{k=1}^{n} k = 1 \times 2 \times \dots \times n

Где \prod — математический оператор произведения элементов от k=1k = 1 до k=nk = n.

Факториал обладает фундаментальным рекуррентным свойством: значение для следующего числа получается простым умножением предыдущего факториала на размер нового шага:

n!=n×(n1)!n! = n \times (n - 1)!

Например, зная, что 4!=244! = 24, мы мгновенно находим 5!=5×4!=5×24=1205! = 5 \times 4! = 5 \times 24 = 120.

Однако эта рекуррентная связь ставит вопрос: чему равен 0!0!? С интуитивной точки зрения «произведение чисел от 1 до 0» звучит бессмысленно, а ответ «ноль» кажется очевидным. Но в математике и анализе данных 0!=10! = 1. К этому выводу ведут сразу три независимых обоснования:

  • Алгебраическое. Развернем рекуррентную формулу в обратную сторону: (n1)!=n!n(n - 1)! = \frac{n!}{n}. Если мы хотим, чтобы соотношение работало для n=1n = 1, подставим единицу: 0!=1!1=11=10! = \frac{1!}{1} = \frac{1}{1} = 1. Если бы 0!0! равнялся нулю, деление на него разрушило бы формулы высшей комбинаторики и распределений вероятностей (например, распределение Пуассона).
  • Комбинаторное. Сколькими способами можно упорядочить множество из 0 элементов (пустое множество \emptyset)? Ровно одним: «ничего не брать и оставить список пустым». Пустое действие — это тоже один конкретный исход.
  • Концепция нейтрального элемента. При сложении нуля слагаемых результатом признается 0 (нейтральный элемент относительно сложения). При умножении нуля сомножителей (пустое произведение) результатом признается 1 — нейтральный элемент относительно умножения.

Масштаб роста: почему факториал останавливает суперкомпьютеры

В алгоритмах машинного обучения и анализе графов мы постоянно сталкиваемся с необходимостью найти «наилучший порядок»: оптимальную последовательность обхода вершин графа (задача коммивояжера), порядок жадного добавления признаков в линейную модель или порядок слоев в пайплайне.

Взглянем на скорость, с которой истощаются вычислительные мощности при попытке решить такую задачу полным перебором перестановок (O(n!)O(n!)):

Число объектов (nn) Значение n!n! Время перебора при 10910^9 операций/сек
55 120120 0,000000120{,}00000012 секунды
1010 36288003\,628\,800 0,00360{,}0036 секунды
1515 1,31×10121{,}31 \times 10^{12} 22\approx 22 минуты
2020 2,43×10182{,}43 \times 10^{18} 77\approx 77 лет
2525 1,55×10251{,}55 \times 10^{25} 492\approx 492 миллиона лет

Увеличение числа параметров всего на 5 позиций (с 15 до 20) превращает задачу, решаемую за чашку кофе, в процесс, превосходящий среднюю продолжительность человеческой жизни. Именно поэтому алгоритмы полного перебора перестановок в Data Science не применяются для задач размерности n>12n > 12.

Когда nn велико, прямое вычисление n!n! вызывает переполнение памяти (integer overflow). Для аналитической работы, вычисления логарифмических функций правдоподобия и энтропии используют формулу приближения Стирлинга:

n!2πn(ne)nn! \approx \sqrt{2 \pi n} \left(\frac{n}{e}\right)^n

В этой формуле:

  • π3,14159\pi \approx 3{,}14159 и e2,71828e \approx 2{,}71828 — фундаментальные математические константы.
  • Множитель (ne)n\left(\frac{n}{e}\right)^n показывает доминирующую часть роста: факториал растет быстрее, чем любая фиксированная экспонента ana^n, поскольку основание дроби растет вместе с nn.
  • Практический пример: для n=10n = 10 точное значение 10!=362880010! = 3\,628\,800. По формуле Стирлинга: 20π×(10/e)107,9266×453999,33598696\sqrt{20\pi} \times (10/e)^{10} \approx 7{,}9266 \times 453\,999{,}3 \approx 3\,598\,696. Относительная погрешность составляет менее 1%, и она стремится к нулю с ростом nn.

В прикладном анализе данных чаще всего работают с логарифмом факториала, заменяя произведение суммой: ln(n!)nlnnn\ln(n!) \approx n \ln n - n. Это позволяет алгоритмам оценивать вероятностные пространства терабайтных выборок без риска переполнения разрядной сетки процессора.

Перестановки на практике: Permutation Importance и статистические тесты

Знание структуры перестановок необходимо не только для оценки сложности алгоритмов, но и для статистических инструментов в Data Science. Рассмотрим два прямых применения.

1. Перестановочная важность признаков (Permutation Feature Importance)

Обучив сложную модель (например, градиентный бустинг), мы хотим знать: насколько признак XjX_j важен для итогового прогноза?

Вместо сложного переобучения модели дата-сайентисты применяют следующий алгоритм:

  1. Фиксируют тестовую выборку и замеряют исходную метрику качества модели (например, ROC-AUC или R2R^2).
  2. Берут столбец признака XjX_j и случайно переставляют в нем значения между объектами (перемешивают строки местами).
  3. Прогоняют модель на выборке с перемешанным столбцом и фиксируют падение качества.

В чем комбинаторный смысл этой процедуры? Перестановка разрушает взаимосвязь признака XjX_j с целевой переменной, но сохраняет одномерное эмпирическое распределение самого признака (среднее, дисперсия и квантили остаются абсолютно прежними, ведь набор чисел не изменился, изменился лишь их порядок). Если признак был критически важен, качество прогноза рушится. Множество всех допустимых перемешиваний для выборки размера NN — это в точности пространство перестановок PN=N!P_N = N!.

2. Точный перестановочный тест (Permutation Test)

Представьте, что при A/B-тестировании нового интерфейса группы оказались маленькими: 4 пользователя в группе A и 4 пользователя в группе B. Мы хотим проверить гипотезу о том, различается ли среднее время сессии между группами, не полагаясь на предположения о нормальности данных (t-тест Стьюдента здесь не надежен).

Нулевая гипотеза (H0H_0) утверждает: разделение на группы не влияет на метрику, эффект равен нулю, а все 8 наблюдений принадлежат одной генеральной совокупности.

Если гипотеза H0H_0 верна, то метки «A» и «B» можно произвольным образом перетасовать между 8 измерениями. Любая перестановка объединенного массива из 8 значений дает один из равновероятных сценариев распределения данных при отсутствии эффекта.

Сравнивая наблюдаемую разницу средних со значениями, полученными на всех возможных перестановках, аналитик вычисляет точное значение p-value как долю перестановок, давших столь же сильное или более экстремальное расхождение:

p=mN!p = \frac{m}{N!}

где N!N! — общее количество способов упорядочить наблюдения (в нашем случае 8!=403208! = 40\,320), а mm — число порядков, приводящих к экстремальной разнице средних. Это прямой мост между комбинаторикой перестановок и проверкой статистических гипотез.

Мы изучили ситуацию, когда упорядочиваются все nn имеющихся объектов. Однако в большинстве практических задач машинного обучения нам не требуется выстраивать абсолютно все элементы. Например, из 100 доступных признаков для компактной модели нужно отобрать только 5 наиболее информативных и расставить их по позициям приоритета. В этом случае слотов оказывается меньше, чем претендентов. К подсчету таких упорядоченных подмножеств мы перейдем в следующей главе.

Размещения и выборки с учётом порядка

Размещения и выборки с учётом порядка

Представьте, что рекомендательная система музыкального сервиса формирует персональный плейлист дня: на витрине пользователя отображаются ровно 3 трека на позициях № 1, № 2 и № 3. Алгоритм отобрал 50 наиболее подходящих композиций-кандидатов. Если бы сервис просто перемешивал все 50 треков между собой, мы получили бы 50!3,04×106450! \approx 3{,}04 \times 10^{64} вариантов — число, превосходящее количество песчинок на Земле. Однако экрану не нужны все 50 треков: требуется заполнить всего 3 позиции, причем порядок строго важен, ведь трек на первой строчке слушают вчетверо чаще, чем на третьей.

Сколько существует способов расставить 3 трека из 50 доступных? Эта прикладная задача подводит нас к фундаментальной операции комбинаторики — частичной перестановке, или размещению.


От полного порядка к выборочному: логика слотов

Когда мы упорядочивали множество целиком, количество слотов для размещения объектов совпадало с числом самих объектов. Если доступно nn элементов, то и позиций было ровно nn. Но на практике мы почти всегда работаем в условиях ограниченных ресурсов:

  • Рекомендательная лента показывает пользователю Top-kk товаров из каталога в nn позиций.
  • Алгоритм пошагового отбора признаков (Forward Feature Selection) выбирает kk наиболее информативных предикторов из базы в nn колонок.
  • На пьедестале соревнований по анализу данных Kaggle есть только 3 призовых места (золото, серебро, бронза), на которые претендуют nn команд.

Поставим строгую комбинаторную задачу: сколькими способами можно выбрать kk различных элементов из генеральной совокупности объемом nn и расставить их по kk пронумерованным позициям (knk \leq n)?

Используем базовое правило умножения и метод последовательного заполнения позиций. Создадим kk упорядоченных ячеек:

  1. Первая позиция (слот 1): мы можем поместить любой из nn доступных объектов. Вариантов выбора: nn.
  2. Вторая позиция (слот 2): один объект уже зафиксирован на первом месте. Повторно использовать его нельзя, поэтому доступно n1n - 1 кандидатов.
  3. Третья позиция (слот 3): заняты уже две позиции, остается выбор из n2n - 2 объектов.
  4. Позиция с номером kk (слот kk): перед заполнением последнего слота мы уже отобрали и распределили k1k - 1 объектов. Следовательно, из исходных nn элементов свободными остаются:

n(k1)=nk+1n - (k - 1) = n - k + 1

По правилу умножения общее число упорядоченных последовательностей длины kk из nn различных элементов равно произведению вариантов на каждом шаге:

n×(n1)×(n2)××(nk+1)n \times (n - 1) \times (n - 2) \times \dots \times (n - k + 1)

Такую конструкцию в математике называют размещением без повторений из nn элементов по kk и обозначают символом AnkA_n^k (от французского arrangement — «размещение», «расположение») либо P(n,k)P(n, k) в англоязычной традиции.

Вернемся к нашему музыкальному сервису, где n=50n = 50, а k=3k = 3:

  • На 1-е место претендуют 50 треков.
  • На 2-е место претендуют 49 треков.
  • На 3-е место претендуют 48 треков.

A503=50×49×48=117600A_{50}^3 = 50 \times 49 \times 48 = 117\,600

Всего 117 600 уникальных вариантов формирования первой тройки. Никакого колоссального масштаба 50!50! здесь нет: процедура остановлена ровно после третьего шага.

Чтобы увидеть, как динамически меняется глубина дерева выбора в зависимости от размера пула nn и количества отбираемых позиций kk, изучите интерактивную модель ниже.


Факториальная форма: искусство отсекать лишнее

Запись в виде длинной цепочки сомножителей n×(n1)××(nk+1)n \times (n - 1) \times \dots \times (n - k + 1) неудобна для алгебраических преобразований, доказательств теорем и компактных расчетов в теории вероятностей. Эту цепочку можно свернуть через факториалы.

Вспомним, что полный факториал n!n! содержит произведение всех натуральных чисел от nn вниз до 1:

n!=n×(n1)××(nk+1)нужные нам k сомножителей×(nk)×(nk1)××2×1лишний "хвост" длиной nkn! = \underbrace{n \times (n - 1) \times \dots \times (n - k + 1)}_{\text{нужные нам } k \text{ сомножителей}} \times \underbrace{(n - k) \times (n - k - 1) \times \dots \times 2 \times 1}_{\text{лишний "хвост" длиной } n - k}

Заметьте: ненужный «хвост» произведения представляет собой не что иное, как факториал оставшихся, не вошедших в выборку объектов, то есть (nk)!(n - k)!.

Если мы разделим полное произведение n!n! на факториал неиспользованного остатка (nk)!(n - k)!, то весь «хвост» взаимно сократится:

Ank=n!(nk)!A_n^k = \frac{n!}{(n - k)!}

Поясним каждый элемент формулы:

  • nn — мощность исходного множества (общее количество доступных объектов, из которых мы выбираем).
  • kk — размер выборки (количество позиций, которые необходимо заполнить, где 0kn0 \leq k \leq n).
  • n!n! — количество способов упорядочить вообще все объекты генеральной совокупности.
  • (nk)!(n - k)! — количество перестановок тех элементов, которые не попали в выборку и порядок которых для нас не имеет значения. Деление на этот член «стирает» внутренние перестановки отсеянных объектов.

Практический расчет формулы

Рассчитаем число способов распределить золотую, серебряную и бронзовую медали среди 8 финалистов хакатона (n=8n = 8, k=3k = 3):

A83=8!(83)!=8!5!=8×7×6×5×4×3×2×15×4×3×2×1=8×7×6=336A_8^3 = \frac{8!}{(8 - 3)!} = \frac{8!}{5!} = \frac{8 \times 7 \times 6 \times 5 \times 4 \times 3 \times 2 \times 1}{5 \times 4 \times 3 \times 2 \times 1} = 8 \times 7 \times 6 = 336

При ручных вычислениях и при проектировании быстрых алгоритмов никогда не вычисляют факториалы больших чисел «в лоб». Вычисление 8!=403208! = 40\,320 с последующим делением на 5!=1205! = 120 нерационально: на больших объемах данных это гарантированно приведет к арифметическому переполнению разрядной сетки (integer overflow). Вместо этого сокращение выполняют аналитически еще до вычислений, сводя расчет к перемножению kk чисел.


Граничные случаи и связь с перестановками

Формула Ank=n!(nk)!A_n^k = \frac{n!}{(n - k)!} математически согласована со всеми ранее изученными свойствами перестановок. Проверим граничные значения параметра kk:

1. Выборка всех доступных элементов (k=nk = n)

Что происходит, если количество слотов равно количеству объектов? Мы должны расставить все nn элементов по всем nn местам:

Ann=n!(nn)!=n!0!=n!1=n!=PnA_n^n = \frac{n!}{(n - n)!} = \frac{n!}{0!} = \frac{n!}{1} = n! = P_n

Полная перестановка без повторений PnP_n — это частный случай размещения, когда длина выборки kk совпадает с объемом совокупности nn. Здесь наглядно подтверждается строгое математическое равенство 0!=10! = 1: без него формула размещений перестала бы работать в критической точке k=nk = n.

2. Выбор одного элемента (k=1k = 1)

Сколькими способами можно выбрать одного победителя конкурса из nn кандидатов? Интуитивно ясно, что таких способов ровно nn:

An1=n!(n1)!=n×(n1)!(n1)!=nA_n^1 = \frac{n!}{(n - 1)!} = \frac{n \times (n - 1)!}{(n - 1)!} = n

3. Пустая выборка (k=0k = 0)

Сколькими способами можно выбрать 0 объектов из множества мощности nn? Ровно одним — не выбирать ничего (пустое множество упорядочено тривиальным образом):

An0=n!(n0)!=n!n!=1A_n^0 = \frac{n!}{(n - 0)!} = \frac{n!}{n!} = 1

Сводная таблица демонстрирует, как меняется поведение AnkA_n^k в зависимости от kk:

Значение kk Алгебраическое выражение Комбинаторный смысл Пример (n=5n = 5)
k=0k = 0 n!n!=1\frac{n!}{n!} = 1 Выбор пустого набора (ровно 1 способ) A50=1A_5^0 = 1
k=1k = 1 n!(n1)!=n\frac{n!}{(n-1)!} = n Выбор единственного лидера A51=5A_5^1 = 5
k<nk < n n×(n1)××(nk+1)n \times (n-1) \times \dots \times (n-k+1) Частичная перестановка (Top-kk элементов) A52=20A_5^2 = 20
k=nk = n n!0!=n!\frac{n!}{0!} = n! Полная перестановка всех элементов A55=120A_5^5 = 120

Размещения в анализе данных и вероятностных моделях

Понимание размещений критически важно в Data Science при решении двух классов задач: вычислении мощностей выборочных пространств в классической вероятности и проектировании алгоритмов ранжирования.

Модель без возвращения и коллизии хеш-функций

Классическая вероятность события AA вычисляется как отношение благоприятных исходов к общему числу исходов: P(A)=mNP(A) = \frac{m}{N}. Если мы проводим серию из kk испытаний без возвращения из совокупности объема nn, то общее число упорядоченных траекторий описывается числом размещений.

Классическая иллюстрация этой схемы — парадокс дней рождения.

Представим группу из kk человек (например, k=23k = 23). Какова вероятность того, что ни у кого из них не совпадет день рождения (предполагаем n=365n = 365 равновероятных дней в году)?

  1. Общее количество всевозможных распределений дат рождения для kk человек (если дни рождения могут повторяться):

N=365×365××365=365kN = 365 \times 365 \times \dots \times 365 = 365^k

(каждый следующий шаг не зависит от предыдущего).

  1. Благоприятные исходы mm, когда у всех kk человек дни рождения приходятся на разные дни. Первый человек может родиться в любой из 365 дней, второй — в любой из оставшихся 364, третий — в любой из 363 и так далее. Это в точности число размещений без повторений A365kA_{365}^k:

m=A365k=365×364××(365k+1)m = A_{365}^k = 365 \times 364 \times \dots \times (365 - k + 1)

Вероятность отсутствия совпадений:

P(все дни разные)=A365k365k=365×364××(365k+1)365kP(\text{все дни разные}) = \frac{A_{365}^k}{365^k} = \frac{365 \times 364 \times \dots \times (365 - k + 1)}{365^k}

При k=23k = 23:

P(все дни разные)0,4927P(\text{все дни разные}) \approx 0{,}4927

Следовательно, вероятность обратного события — того, что хотя бы у двух человек из 23 совпадет день рождения:

10,4927=0,5073(50,7%)1 - 0{,}4927 = 0{,}5073 \quad (\approx 50{,}7\%)

Этот же математический аппарат лежит в основе оценки коллизий хеш-функций в распределенных хранилищах данных (Hash Ring, базы данных NoSQL): если kk независимых ключей случайным образом отображаются в пространство хешей размера nn, то отсутствие коллизий требует упорядоченного размещения kk уникальных хешей из nn доступных слотов.

Ранжирование и метрики Top-kk

В задачах информационного поиска (Information Retrieval) и поисковых системах алгоритмы машинного обучения оптимизируют выдачу не по бинарному принципу «нашел / не нашел», а с учетом порядка. Выдача kk релевантных документов из найденных nn кандидатов — это упорядоченный кортеж.

Если поисковый робот нашел по запросу 10 релевантных статей (n=10n = 10) и выводит на первую страницу выдачи ровно 4 ссылки (k=4k = 4), то число всевозможных вариантов выдачи составляет:

A104=10×9×8×7=5040A_{10}^4 = 10 \times 9 \times 8 \times 7 = 5\,040

Если алгоритм идеального ранжирования предполагает строго одну правильную последовательность документов по степени убывания пользы (от наиболее авторитетного к менее авторитетному), то вероятность того, что случайная модель угадает эту эталонную выдачу Top-4, равна:

P(идеальный Top-4)=1A104=150400,000198(0,02%)P(\text{идеальный Top-4}) = \frac{1}{A_{10}^4} = \frac{1}{5\,040} \approx 0{,}000198 \quad (0{,}02\%)

Именно поэтому в задачах ранжирования используются специализированные метрики (например, MRR — Mean Reciprocal Rank, NDCG — Normalized Discounted Cumulative Gain), которые штрафуют алгоритм за ошибки в первых слотах размещения гораздо строже, чем за ошибки на последних позициях.


Архитектура перебора признаков: Greedy Forward Selection

Рассмотрим, как комбинаторика размещений объясняет выбор субоптимальных эвристик в машинном обучении.

В задаче регрессии у нас есть n=30n = 30 сырых признаков. Мы хотим отобрать модель, содержащую ровно k=5k = 5 признаков, упорядоченных по степени их добавления в конвейер. Если порядок добавления признаков имеет значение (например, каждый следующий шаг оценивает остаточную ошибку предыдущей комбинации):

A305=30×29×28×27×26=17100720A_{30}^5 = 30 \times 29 \times 28 \times 27 \times 26 = 17\,100\,720

Полный перебор семнадцати миллионов конфигураций моделей требует огромных вычислительных ресурсов.

Чтобы избежать комбинаторного тупика, алгоритм жадного прямого включения (Greedy Forward Selection) заменяет глобальное размещение серией локальных шагов:

  1. На первом шаге обучаются nn моделей (по 1 признаку) и выбирается наилучший.
  2. На втором шаге признак-победитель фиксируется в первом слоте, а среди оставшихся n1n - 1 признаков ищется второй.
  3. Процедура повторяется kk раз.

Вместо произведения A3051,71×107A_{30}^5 \approx 1{,}71 \times 10^7 алгоритм выполняет сумму операций:

30+29+28+27+26=140 обучений моделей30 + 29 + 28 + 27 + 26 = 140 \text{ обучений моделей}

Анализ формулы размещений позволяет инженеру данных четко понимать: где перебор в пространстве AnkA_n^k физически допустим, а где факториальный рост требует перехода к жадным или вероятностным эвристикам.


Главный вопрос порядка

Мы подробно изучили ситуации, когда порядок элементов в выборке играет определяющую роль:

  • в музыкальном плейлисте важен трек-хедлайнер на первом месте;
  • на пьедестале почета золото качественно отличается от бронзы;
  • в хеш-таблице последовательность ключей определяет адресацию ячеек.

Во всех этих случаях перестановка элементов внутри уже выбранного подмножества порождает новый исход: набор (Трек A, Трек B) не эквивалентен набору (Трек B, Трек A).

Но что произойдет, если порядок элементов перестанет иметь значение?

Представьте, что из тех же 50 треков нам нужно собрать архивный zip-файл из 3 песен для фонового скачивания, или из 30 признаков в датасете отобрать 5 для одновременного обучения линейной модели y=w1x1++w5x5y = w_1 x_1 + \dots + w_5 x_5, где слагаемые коммутативны. Сколько вариантов останется, если перестановки внутри группы перестанут считаться уникальными комбинациями? Ответ на этот вопрос дает следующая операция комбинаторики — сочетания.

Сочетания и биномиальные коэффициенты

Сочетания и биномиальные коэффициенты

Если алгоритм обучает модель на трёх признаках, ему совершенно безразлично, в каком порядке они подаются на вход: матрица с колонками [возраст, доход, стаж] несёт ровно ту же информацию, что и [доход, стаж, возраст]. Для каталога из 10 доступных признаков число упорядоченных троек составляет A103=10×9×8=720A_{10}^3 = 10 \times 9 \times 8 = 720. Однако обучать 720 моделей бессмысленно — подавляющее большинство из них обучится на одном и том же наборе данных.

Сколько действительно уникальных подмножеств признаков можно собрать из десяти кандидатов, если порядок внутри выборки не имеет никакого значения?

От порядка к составу: рождение сочетаний

Каждый раз, когда порядок элементов перестаёт играть роль, пространство исходов резко сжимается. Возьмём конкретную тройку признаков: {A,B,C}\{A, B, C\}. В рамках размещений эта тройка порождает несколько разных кортежей:

  • (A,B,C)(A, B, C)
  • (A,C,B)(A, C, B)
  • (B,A,C)(B, A, C)
  • (B,C,A)(B, C, A)
  • (C,A,B)(C, A, B)
  • (C,B,A)(C, B, A)

Все эти 6 цепочек представляют собой перестановки одних и тех же трёх элементов. Их количество в точности равно 3!=3×2×1=63! = 3 \times 2 \times 1 = 6. С точки зрения состава подмножества все 6 вариантов неразличимы: это одна и та же группа {A,B,C}\{A, B, C\}.

Значит, каждый уникальный неупорядоченный набор из kk элементов оказывается посчитан ровно k!k! раз внутри общего числа размещений AnkA_n^k.

Чтобы исключить избыточный учёт перестановок, достаточно разделить общее количество упорядоченных выборок на число внутренних перестановок внутри группы:

Cnk=(nk)=Ankk!=n!k!(nk)!C_n^k = \binom{n}{k} = \frac{A_n^k}{k!} = \frac{n!}{k!(n - k)!}

Разберём каждый компонент этой формулы на практике:

  • nn — мощность исходного множества (генеральная совокупность кандидатов).
  • kk — размер формируемой выборки (сколько объектов мы забираем).
  • n!n! — общее число способов выстроить все nn объектов в одну непрерывную цепочку.
  • (nk)!(n - k)! в знаменателе отсекает упорядочивание тех элементов, которые остались за бортом выборки (как в размещениях).
  • k!k! в знаменателе устраняет учёт порядка между теми kk элементами, которые вошли в выборку.

Символ (nk)\binom{n}{k} читается как «CC из nn по kk» или «биномиальный коэффициент».

Вернёмся к выбору 3 признаков из 10:

C103=10!3!×(103)!=10×9×83×2×1=7206=120C_{10}^3 = \frac{10!}{3! \times (10 - 3)!} = \frac{10 \times 9 \times 8}{3 \times 2 \times 1} = \frac{720}{6} = 120

Вместо 720 дорогостоящих обучений моделей Data Scientist оценивает ровно 120 уникальных конфигураций признаков.

Тип выборки Влияет ли порядок? Формула Число выборок 3 из 10
Размещение (AnkA_n^k) Да (ранжирование, очередь) n!(nk)!\frac{n!}{(n - k)!} 720
Сочетание (CnkC_n^k) Нет (команда, подмножество) n!k!(nk)!\frac{n!}{k!(n - k)!} 120

Анатомия биномиального коэффициента: симметрия и крайние точки

Формула CnkC_n^k обладает выраженной симметрией. Если в выражении n!k!(nk)!\frac{n!}{k!(n - k)!} заменить kk на nkn - k, знаменатель не изменится: множители просто поменяются местами.

Свойство симметрии:

(nk)=(nnk)\binom{n}{k} = \binom{n}{n - k}

Практический смысл симметрии очевиден: выбрать kk объектов, которые войдут в выборку, — это в точности то же самое, что выбрать nkn - k объектов, которые останутся за бортом.

  • Разбить датасет из 100 строк на обучающую выборку (80 строк) и тестовую (20 строк) можно (10080)\binom{100}{80} способами.
  • Выбрать 20 тестовых строк из 100 можно (10020)\binom{100}{20} способами.
  • Значения (10080)\binom{100}{80} и (10020)\binom{100}{20} строго равны. Вычисление через меньший индекс экономит арифметические действия: 100×99××8120!\frac{100 \times 99 \times \dots \times 81}{20!} считать дольше, чем сразу разложить формулу относительно 20 множителей.

Проверим граничные значения формулы:

  • (n0)=n!0!×n!=1\binom{n}{0} = \frac{n!}{0! \times n!} = 1: существует ровно один способ не выбрать ни одного объекта (пустое множество).
  • (nn)=n!n!×0!=1\binom{n}{n} = \frac{n!}{n! \times 0!} = 1: существует единственный способ забрать все элементы разом.
  • (n1)=n!1!×(n1)!=n\binom{n}{1} = \frac{n!}{1! \times (n - 1)!} = n: выбрать один объект из nn кандидатов можно ровно nn способами.

Рекуррентное правило и треугольник Паскаля

Представим команду из nn аналитиков, в которой работает ведущий эксперт Анна. Нам нужно сформировать рабочую группу из kk человек. Разобьём все возможные группы на две взаимоисключающие категории по правилу сложения:

  1. Группы, куда Анна вошла. Анна уже заняла одно место. Осталось добрать k1k - 1 человек из оставшихся n1n - 1 коллег. Это даёт (n1k1)\binom{n - 1}{k - 1} вариантов.
  2. Группы, куда Анна не вошла. Анна исключена из рассмотрения. Все kk мест заполняются оставшимися n1n - 1 кандидатами. Это даёт (n1k)\binom{n - 1}{k} вариантов.

Поскольку эти два случая не пересекаются и исчерпывают все исходы, получаем тождество Паскаля:

(nk)=(n1k1)+(n1k)\binom{n}{k} = \binom{n - 1}{k - 1} + \binom{n - 1}{k}

Например, для выбора 3 человек из 5:

(53)=(42)+(43)=6+4=10\binom{5}{3} = \binom{4}{2} + \binom{4}{3} = 6 + 4 = 10

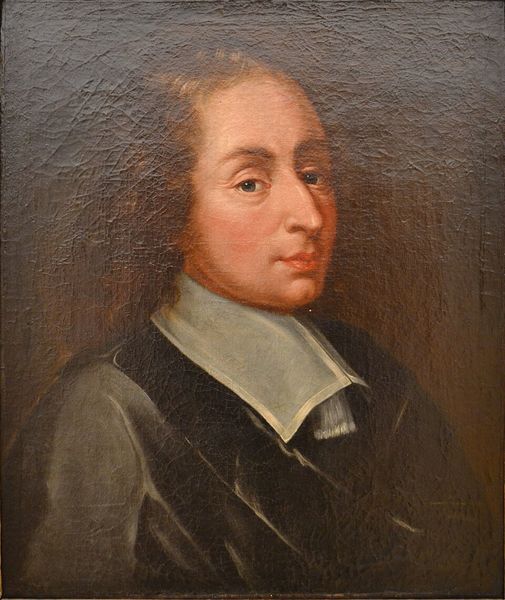
Портрет Блеза Паскаля

Это тождество порождает треугольник Паскаля — числовую таблицу, где каждое число равно сумме двух стоящих над ним чисел. Строки нумеруются с n=0n = 0, позиции в строке — с k=0k = 0:

  • Строка 0 (n=0n = 0): 11
  • Строка 1 (n=1n = 1): 111 \quad 1
  • Строка 2 (n=2n = 2): 1211 \quad 2 \quad 1
  • Строка 3 (n=3n = 3): 13311 \quad 3 \quad 3 \quad 1
  • Строка 4 (n=4n = 4): 146411 \quad 4 \quad 6 \quad 4 \quad 1
  • Строка 5 (n=5n = 5): 151010511 \quad 5 \quad 10 \quad 10 \quad 5 \quad 1

В строке под номером nn значения растут от краёв к центру, достигая пика при k=n/2k = n / 2 (для чётных nn) или на двух центральных значениях при k=(n1)/2k = (n - 1)/2 и k=(n+1)/2k = (n + 1)/2 (для нечётных nn).

Бином Ньютона и суммарная мощность пространства подмножеств

Коэффициенты треугольника Паскаля возникают при раскрытии скобок в выражении (a+b)n(a + b)^n. Рассмотрим произведение nn одинаковых множителей:

(a+b)n=(a+b)(a+b)(a+b)n скобок(a + b)^n = \underbrace{(a + b)(a + b)\dots(a + b)}_{n \text{ скобок}}

Когда мы перемножаем эти скобки, каждое слагаемое в итоговой сумме формируется выбором либо слагаемого aa, либо слагаемого bb из каждой отдельной скобки.

Чтобы получить одночлен вида ankbka^{n - k} b^k, нам необходимо выбрать слагаемое bb ровно из kk скобок, а из оставшихся nkn - k скобок автоматически взять aa. Сколькими способами можно указать те kk скобок, откуда будет извлечена переменная bb? Ровно (nk)\binom{n}{k} способами.

Отсюда вытекает теорема о биноме Ньютона:

(a+b)n=k=0n(nk)ankbk(a + b)^n = \sum_{k = 0}^{n} \binom{n}{k} a^{n - k} b^k

Разберём составляющие формулы:

  • k=0n\sum_{k = 0}^n — знак суммы по всем возможным размерам выборки kk от 0 до nn.
  • (nk)\binom{n}{k} — биномиальный коэффициент, отражающий кратность одночлена.
  • ankbka^{n - k} b^k — мономы степени nn.

Например, при n=3n = 3:

(a+b)3=(30)a3+(31)a2b+(32)ab2+(33)b3=a3+3a2b+3ab2+b3(a + b)^3 = \binom{3}{0}a^3 + \binom{3}{1}a^2 b + \binom{3}{2}a b^2 + \binom{3}{3}b^3 = a^3 + 3a^2 b + 3a b^2 + b^3

Если подставить в формулу бинома a=1a = 1 и b=1b = 1, получается фундаментальное соотношение:

(1+1)n=k=0n(nk)1nk1k    k=0n(nk)=2n(1 + 1)^n = \sum_{k = 0}^n \binom{n}{k} 1^{n - k} 1^k \implies \sum_{k = 0}^n \binom{n}{k} = 2^n

Это равенство имеет прямое комбинаторное толкование: сумма биномиальных коэффициентов по всем kk равна общему числу всех возможных подмножеств множества из nn элементов (булеану). Для каждого из nn объектов у нас есть 2 исхода — либо включить его в подмножество, либо нет. По правилу умножения получаем 2×2××2=2n2 \times 2 \times \dots \times 2 = 2^n.

Прикладной контекст: от сочетаний к биномиальному распределению

В машинном обучении и A/B-тестировании сочетания выступают математическим каркасом вероятностных моделей.

Перебор признаков (Feature Selection)

Если датасет содержит n=20n = 20 признаков, полный перебор всех возможных непустых комбинаций признаков потребует обучения:

k=120(20k)=2201=1048575 моделей\sum_{k = 1}^{20} \binom{20}{k} = 2^{20} - 1 = 1\,048\,575 \text{ моделей}

Число 2n2^n растёт экспоненциально, что делает исчерпывающий перебор невозможным уже при n40n \geq 40, вынуждая инженеров применять жадные эвристики и регуляризацию.

A/B-тесты и распределение Бернулли

В A/B-тестировании конверсия пользователя — это бинарный исход: клик (успех с вероятностью pp) или отказ (неудача с вероятностью 1p1 - p).

Если посадочную страницу посетили nn пользователей, какова вероятность зафиксировать ровно kk конверсий?

Любая конкретная последовательность из kk успехов и nkn - k неудач (например, сначала все kk кликнули, затем nkn - k ушли) имеет вероятность pk(1p)nkp^k (1 - p)^{n - k}. Но эти kk успехов могут распределиться среди nn посещений в любом порядке: кликнуть могут первые kk человек, последние kk, или они распределятся равномерно по всей выборке.

Число способов расставить kk событий успеха по nn независимым испытаниям — это в точности число сочетаний (nk)\binom{n}{k}.

Так рождается формула биномиального распределения:

P(X=k)=(nk)pk(1p)nkP(X = k) = \binom{n}{k} p^k (1 - p)^{n - k}

Здесь биномиальный коэффициент служит весовым множителем: он показывает, сколько элементарных путей ведёт к суммарному итогу в kk успехов. Без понимания природы сочетаний невозможно корректно рассчитывать доверительные интервалы, проводить z-тесты пропорций и оценивать статистическую значимость экспериментов в аналитике данных.

Выборки и перестановки с повторениями

Выборки и перестановки с повторениями

До сих пор каждый выбор подчинялся строгому ограничению: взятый элемент выбывал из игры, а все объекты множества считались различимыми. Мы считали перестановки уникальных этапов конвейера, формировали рейтинги Top-kk из разных кандидатов и собирали признаковые подмножества в булеане. Но реальные данные редко состоят из неповторимых сущностей.

В текстах буквы и токены дублируются: в слове «параллелепипед» или коде ДНК «AAGCTTA» элементы повторяются многократно. При генерации паролей или синтезе последовательностей один и тот же символ можно выбирать снова и снова. А алгоритм бэггинга в машинном обучении извлекает строки из обучающей выборки с обязательным возвращением назад. Как меняются базовые законы комбинаторики, когда элементы перестают быть уникальными или возвращаются в пул кандидатов?


Размещения с повторениями: независимый выбор с возвратом

Когда каждый выбранный элемент немедленно возвращается обратно в генеральную совокупность, мощность пула доступных альтернатив перестает убывать. Каждый следующий шаг делается в тех же условиях, что и предыдущий.

Пусть у нас есть алфавит мощности nn, и мы составляем из него упорядоченную последовательность длины kk. На первой позиции может стоять любой из nn символов. Поскольку выбранный символ не изымается, на второй позиции вновь доступно ровно nn претендентов. По правилу умножения для независимых шагов общее число таких цепочек вычисляется возведением в степень:

Aˉnk=nk\bar{A}_n^k = n^k

В этой формуле:

  • nn — мощность исходного алфавита (число уникальных типов объектов, доступных для выбора);
  • kk — длина формируемой последовательности (число шагов или слотов);
  • Aˉnk\bar{A}_n^k — число всех возможных упорядоченных последовательностей длины kk с повторениями.

С практической точки зрения ключевое отличие от размещений без повторений (AnkA_n^k) заключается в том, что длина выборки kk больше не ограничена размером алфавита nn. Мы легко можем составить вектор длины k=100k = 100 из алфавита n=2n = 2 символов.

Пример из практики. Допустим, мы генерируем категориальный хеш-вектор длины k=4k = 4 из шестнадцатеричных символов (алфавит от 0 до F, то есть n=16n = 16). Число уникальных идентификаторов равно:

164=6553616^4 = 65\,536

Если бы символы не возвращались, число исходов составило бы лишь A164=16×15×14×13=43680A_{16}^4 = 16 \times 15 \times 14 \times 13 = 43\,680. Разрешение повторений существенно расширяет емкость пространства адресов при фиксированной длине вектора.


Перестановки с повторениями и мультиномиальный коэффициент

Совершенно иная комбинаторная задача возникает, когда набор элементов задан целиком, но среди них есть одинаковые, неразличимые между собой объекты. Такую структуру называют мультимножеством.

Рассмотрим слово «ДАТА». В нем 4 буквы, однако буква «А» встречается 2 раза, а «Д» и «Т» — по 1 разу. Если бы все буквы были помечены уникальными индексами (Д1,А1,Т1,А2\text{Д}_1, \text{А}_1, \text{Т}_1, \text{А}_2), мы получили бы стандартные 4!=244! = 24 перестановки. Однако физическая замена А1\text{А}_1 и А2\text{А}_2 местами в слове «ДАТА» не создает новой строки: «Д А1\text{А}_1 Т А2\text{А}_2» и «Д А2\text{А}_2 Т А1\text{А}_1» неразличимы для парсера.

Чтобы устранить этот избыточный учет, применим уже знакомый принцип факторизации: разделим общее число перестановок n!n! на количество внутренних перестановок внутри групп одинаковых элементов. Для слова «ДАТА» получаем:

4!1!×2!×1!=242=12 уникальных анаграмм.\frac{4!}{1! \times 2! \times 1!} = \frac{24}{2} = 12 \text{ уникальных анаграмм.}

Обобщим эту логику на произвольное число групп. Пусть имеется совокупность из nn объектов, разделенных на mm классов: k1k_1 объектов первого типа, k2k_2 объектов второго типа, \dots, kmk_m объектов mm-го типа, причем их сумма строго равна объему выборки:

k1+k2++km=nk_1 + k_2 + \dots + k_m = n

Число уникальных перестановок такого мультимножества задается формулой:

Pn(k1,k2,,km)=n!k1!×k2!××km!P_{n}(k_1, k_2, \dots, k_m) = \frac{n!}{k_1! \times k_2! \times \dots \times k_m!}

Где:

  • nn — общее число позиций в результирующей последовательности;
  • kik_i — кратность (число вхождений) элементов ii-го типа;
  • ki!k_i! в знаменателе — поправка на неразличимость перестановок одинаковых элементов внутри своей группы.

Эта величина называется мультиномиальным коэффициентом и обозначается как (nk1,k2,,km)\binom{n}{k_1, k_2, \dots, k_m}.

Обратите внимание на связь с предыдущим материалом: биномиальный коэффициент CnkC_n^k — это частный случай мультиномиального при m=2m = 2 классах (например, kk успехов и nkn - k неудач):

(nk,nk)=n!k!(nk)!=Cnk\binom{n}{k, n-k} = \frac{n!}{k!(n-k)!} = C_n^k

Если биномиальный коэффициент считает число способов расставить бинарные флаги (0 и 1) по nn позициям, то мультиномиальный решает задачу раскладки nn разнородных объектов по mm маркированным корзинам фиксированной вместимости (k1,k2,,kmk_1, k_2, \dots, k_m).

Пример из практики. Представьте конвейер тестирования из n=9n = 9 микросервисов. Мы распределяем их по трем стендам нагрузки: на стенд High-Load отправляются k1=4k_1 = 4 сервиса, на Standard — k2=3k_2 = 3, на Debug — оставшиеся k3=2k_3 = 2. Сколькими способами можно сформировать такую конфигурацию?

(94,3,2)=9!4!×3!×2!=36288024×6×2=1260 вариантов.\binom{9}{4, 3, 2} = \frac{9!}{4! \times 3! \times 2!} = \frac{362\,880}{24 \times 6 \times 2} = 1\,260 \text{ вариантов.}


Метод перегородок: сочетания с повторениями

Размещения и перестановки с повторениями сохраняли порядок следования элементов. Но что происходит, если порядок нам безразличен, а элементы одного типа можно выбирать многократно?

Типичная инженерная задача: распределить kk неразличимых запросов вычислительной нагрузки по nn доступным серверам кластера. Сервер может получить несколько запросов, один запрос или не получить вовсе. Нам не важно, в каком порядке запросы поступают на конкретный узел, критично лишь итоговое количество задач на каждом из них.

В терминах комбинаторики это сочетания с повторениями: выбор неупорядоченного мультимножества мощности kk из nn доступных категорий.

Прямой перебор таких конфигураций сложен, но задача элегантно сводится к обычному биномиальному коэффициенту с помощью метода шаров и перегородок (Stars and Bars).

Представим kk неразличимых запросов в виде цепочки символов-шаров: \bullet \bullet \dots \bullet. Чтобы разделить их между nn серверами, достаточно расставить между шарами ровно n1n - 1 перегородку |.

Рассмотрим пример: k=5k = 5 задач распределяются по n=3n = 3 серверам:

\bullet \bullet \mid \bullet \mid \bullet \bullet

Эта запись кодирует исход:

  • Первый сервер получил 2 задачи;
  • Второй сервер получил 1 задачу;
  • Третий сервер получил 2 задачи.

Если две перегородки стоят подряд (\bullet \bullet \mid \mid \bullet \bullet \bullet), средний сервер получил 0 задач. Если перегородка стоит в самом начале (\mid \bullet \bullet \bullet \mid \bullet \bullet), первый сервер остался пустым.

Любое допустимое распределение взаимно однозначно соответствует последовательности из kk шаров и n1n - 1 перегородок. Суммарная длина такой символьной строки составляет:

k+(n1) позиций.k + (n - 1) \text{ позиций.}

Задача свелась к базовому вопросу: сколькими способами можно выбрать места для kk шаров (или, что эквивалентно, для n1n - 1 перегородок) из общего числа позиций n+k1n + k - 1? Ответ дает сочетание без повторений:

Cˉnk=Cn+k1k=(n+k1)!k!(n1)!\bar{C}_n^k = C_{n+k-1}^k = \frac{(n + k - 1)!}{k! (n - 1)!}

Где:

  • nn — количество типов объектов (или число доступных корзин/контейнеров);
  • kk — суммарное количество неразличимых выбираемых объектов (шаров);
  • n1n - 1 — количество виртуальных перегородок, разделяющих корзины;
  • Cˉnk\bar{C}_n^k — число возможных неупорядоченных наборов с повторениями.

Пример из практики. Аналитик собирает синтетический датасет для стресс-теста модели. Нужно распределить k=7k = 7 однотипных признаков-заглушек по n=4n = 4 слоям глубокой нейронной сети. Число возможных архитектурных схем распределения равно:

Cˉ47=C4+717=C107=10!7!×3!=10×9×83×2×1=120 конфигураций.\bar{C}_4^7 = C_{4 + 7 - 1}^7 = C_{10}^7 = \frac{10!}{7! \times 3!} = \frac{10 \times 9 \times 8}{3 \times 2 \times 1} = 120 \text{ конфигураций.}


Полная карта комбинаторных выборок

Теперь мы можем свести воедино все базовые схемы подсчета. Любая комбинаторная задача о выборке kk элементов из генеральной совокупности объема nn классифицируется по двум бинарным осям:

  1. Порядок исходов: важен (последовательность) или не важен (состав подмножества).
  2. Повторение элементов: запрещено (выборка без возвращения) или разрешено (выборка с возвращением).
Режим выбора Без повторений (уникальные элементы) С повторениями (с возвратом / одинаковые типы)
Упорядоченный (порядок важен) Размещения: Ank=n!(nk)!A_n^k = \frac{n!}{(n - k)!} Размещения с повторениями: Aˉnk=nk\bar{A}_n^k = n^k
Неупорядоченный (порядок безразличен) Сочетания: Cnk=n!k!(nk)!C_n^k = \frac{n!}{k!(n - k)!} Сочетания с повторениями: Cˉnk=Cn+k1k\bar{C}_n^k = C_{n + k - 1}^k

Эта матрица — главный навигатор комбинаторики. Перед тем как выписывать факториалы, задайте себе два вопроса:

  • Меняется ли результат при перестановке двух элементов местами? Если да — вы в верхней строке (размещения). Если нет — в нижней (сочетания).
  • Может ли один и тот же физический объект или тип быть задействован повторно? Если нет — левый столбец. Если да — правый столбец.

Прикладной контекст: от мешка слов до мультиномиального распределения

Выборки и перестановки с повторениями формируют фундамент вероятностных моделей в обработке естественного языка (NLP) и классическом машинном обучении.

1. Мешок слов (Bag of Words) и языковое моделирование

Когда документ представляется в виде мультимножества слов, порядок токенов в предложении часто игнорируется, но частота каждого слова строго фиксируется. Если словарь содержит VV уникальных лексем, то короткий документ из kk слов — это неупорядоченная выборка с повторениями, число возможных профилей которой описывается величиной CˉVk\bar{C}_V^k.

Если же мы строим генеративную модель (например, nn-граммы), где порядок токенов критичен, каждая позиция текста предсказывается из словаря объема VV. Пространство возможных предложений длины kk взрывается как VkV^k.

2. Мультиномиальное распределение вероятностей

В анализе данных мультиномиальный коэффициент непосредственно порождает мультиномиальное распределение — прямое обобщение биномиального закона на случай mm взаимоисключающих исходов.

Если событие может завершиться одним из mm исходов с вероятностями p1,p2,,pmp_1, p_2, \dots, p_m (причем pi=1\sum p_i = 1), то вероятность наблюдать в серии из nn независимых испытаний ровно k1k_1 исходов первого типа, k2k_2 второго и kmk_m последнего равна произведению мультиномиального коэффициента на соответствующие вероятности:

P(X1=k1,,Xm=km)=n!k1!×k2!××km!×p1k1×p2k2××pmkmP(X_1 = k_1, \dots, X_m = k_m) = \frac{n!}{k_1! \times k_2! \times \dots \times k_m!} \times p_1^{k_1} \times p_2^{k_2} \times \dots \times p_m^{k_m}

Пояснение элементов формулы:

  • nn — общее число проведенных независимых испытаний (размер выборки);
  • k1,,kmk_1, \dots, k_m — зафиксированные количества наступлений каждого из mm событий (ki=n\sum k_i = n);
  • p1,,pmp_1, \dots, p_m — элементарные вероятности наступления каждого события в одном испытании;
  • Мультиномиальный коэффициент n!k1!km!\frac{n!}{k_1! \dots k_m!} подсчитывает точное количество элементарных цепочек испытаний, приводящих к требуемому итоговому составу.

Практический пример. В задаче многоклассовой классификации модель категоризирует обращения пользователей на 3 типа: «Технический сбой» (p1=0,5p_1 = 0{,}5), «Вопрос по оплате» (p2=0,3p_2 = 0{,}3) и «Спам» (p3=0,2p_3 = 0{,}2).

Какова вероятность того, что из следующих n=5n = 5 поступивших тикетов ровно 2 окажутся сбоями, 2 — вопросами по оплате и 1 — спамом? Сначала считаем число конфигураций:

(52,2,1)=5!2!×2!×1!=1204=30\binom{5}{2, 2, 1} = \frac{5!}{2! \times 2! \times 1!} = \frac{120}{4} = 30

Затем перемножаем вероятности реализации каждого исхода в цепочке:

P=30×(0,5)2×(0,3)2×(0,2)1=30×0,25×0,09×0,2=0,135 (или 13,5%).P = 30 \times (0{,}5)^2 \times (0{,}3)^2 \times (0{,}2)^1 = 30 \times 0{,}25 \times 0{,}09 \times 0{,}2 = 0{,}135 \text{ (или } 13{,}5\%\text{).}

Без мультиномиального коэффициента мы учли бы только один конкретный порядок поступления тикетов (например, строго «Сбой-Сбой-Оплата-Оплата-Спам»), занизив истинную вероятность ровно в 30 раз.

Принцип включений-исключений

Принцип включений-исключений

В первой главе мы сформулировали базовое правило сложения: если варианты взаимно исключают друг друга, их количества просто складываются. Но что происходит в реальных данных, где границы категорий размыты, а события постоянно накладываются друг на друга?

Представьте типичную задачу продуктовой аналитики. Мобильным приложением пользуются клиенты из разных каналов привлечения: 120 тысяч пришли через поисковую рекламу, а 90 тысяч — через рекомендации блогеров. Если без оглядки применить простое сложение, получится 210 тысяч пользователей. Однако в логах авторизации обнаруживается всего 160 тысяч уникальных идентификаторов. Куда исчезли 50 тысяч человек? Они никуда не исчезали: эти 50 тысяч пользователей кликнули по обоим каналам и при наивном суммировании были посчитаны дважды.

Проблема совместных событий возникает повсеместно: от расчета уникального охвата рекламных кампаний до анализа сетевого трафика и оценки вероятностей редких сбоев в распределенных системах. Чтобы находить точный размер объединения пересекающихся групп, комбинаторика предлагает строгий и элегантный инструмент — принцип включений-исключений.

Два множества: устранение двойного учета

Начнем с фундаментального случая двух пересекающихся множеств AA и BB. Мощность множества (число входящих в него уникальных элементов) обозначается вертикальными чертами: A|A| и B|B|.

Если множества пересекаются, то в сумму A+B|A| + |B| элементы их общей зоны — пересечения ABA \cap B — попадают ровно два раза: один раз в составе AA, а второй раз в составе BB. Чтобы восстановить истинный размер объединения ABA \cup B, этот избыточный второй слой необходимо вычесть.

AB=A+BAB|A \cup B| = |A| + |B| - |A \cap B|

В этой формуле:

  • AB|A \cup B| — число элементов, принадлежащих хотя бы одному из множеств (объединение).
  • A|A| и B|B| — размеры исходных групп, включенные в первоначальную сумму.
  • AB|A \cap B| — число элементов, одновременно входящих и в AA, и в BB (пересечение), исключаемое для устранения дублирования.

Вернемся к нашему примеру с пользователями:

  • Реклама в поиске (AA): A=120|A| = 120 тысяч.
  • Блогеры (BB): B=90|B| = 90 тысяч.
  • Оба источника (ABA \cap B): AB=50|A \cap B| = 50 тысяч.

Считаем общий уникальный охват:

AB=120+9050=160 тысяч.|A \cup B| = 120 + 90 - 50 = 160\text{ тысяч.}

Баланс сошелся с логами. Каждого человека из группы ABA \cap B мы сначала учли дважды (+1+1 от AA и +1+1 от BB), а затем один раз вычли (1-1 от ABA \cap B). Итоговый вклад каждого пользователя равен ровно 11.

Три множества: волновой эффект компенсаций

Когда пересекающихся групп становится три — AA, BB и CC, — логика исправления ошибок усложняется. Просто сложить размеры трех групп и вычесть все парные пересечения уже недостаточно.

Разберем, какой след оставляет каждый элемент в итоговой сумме в зависимости от того, в скольких множествах он состоит:

  1. Элемент принадлежит только одному множеству (например, только AA). Он входит в слагаемое A|A| ровно 1 раз и ни в какие парные пересечения не попадает. Итоговый вес: +1+1.
  2. Элемент принадлежит ровно двум множествам (например, AA и BB, но не CC). Он входит в A|A| и B|B| (1+1=21 + 1 = 2 раза), а затем вычитается в парном пересечении AB|A \cap B|. Итоговый вес: 21=12 - 1 = 1.
  3. Элемент принадлежит всем трем множествам сразу (ABCA \cap B \cap C). Следим за его судьбой:
    • При сложении отдельных множеств (A+B+C|A| + |B| + |C|) он посчитан 1+1+1=31 + 1 + 1 = 3 раза.
    • При вычитании парных пересечений (AB+AC+BC|A \cap B| + |A \cap C| + |B \cap C|) он входит в каждое из них, то есть вычитается 1+1+1=31 + 1 + 1 = 3 раза.
    • Баланс центральной зоны обнулился: 33=03 - 3 = 0. Элементы из самого центра формулы полностью стерлись из итогового подсчета.

Чтобы вернуть элементы центральной зоны обратно, необходимо компенсировать избыточное вычитание и прибавить тройное пересечение.

ABC=A+B+CABACBC+ABC|A \cup B \cup C| = |A| + |B| + |C| - |A \cap B| - |A \cap C| - |B \cap C| + |A \cap B \cap C|

В этой формуле:

  • A+B+C|A| + |B| + |C| — сумма мощностей отдельных множеств (первый порядок, знак плюс).
  • AB+AC+BC|A \cap B| + |A \cap C| + |B \cap C| — сумма всех возможных парных пересечений, их число равно числу сочетаний C32=3C_3^2 = 3 (второй порядок, знак минус).
  • ABC|A \cap B \cap C| — пересечение всех трех множеств, число таких троек равно C33=1C_3^3 = 1 (третий порядок, знак плюс).

Практический расчет: стек технологий в резюме

Аналитический отдел исследовал базу из 1000 кандидатов на вакансию Data Scientist по трем ключевым навыкам: знание Python (PP), SQL (SS) и математической статистики (MM). Данные анкетирования показали:

  • Знают Python (P|P|): 650 человек
  • Знают SQL (S|S|): 550 человек
  • Знают статистику (M|M|): 450 человек
  • Знают Python и SQL (PS|P \cap S|): 350 человек
  • Знают Python и статистику (PM|P \cap M|): 250 человек
  • Знают SQL и статистику (SM|S \cap M|): 200 человек
  • Владеют всеми тремя инструментами (PSM|P \cap S \cap M|): 100 человек

Сколько кандидатов владеют хотя бы одним из этих навыков?

PSM=(650+550+450)(350+250+200)+100|P \cup S \cup M| = (650 + 550 + 450) - (350 + 250 + 200) + 100

PSM=1650800+100=950 человек.|P \cup S \cup M| = 1650 - 800 + 100 = 950\text{ человек.}

Следовательно, кандидатов без единого профильного навыка из этого списка осталось ровно 1000950=501000 - 950 = 50 человек.

Общий принцип для nn множеств

Закономерность, проявившаяся для двух и трех множеств, сохраняется для любого числа групп. Знаки слагаемых строго чередуются:

  1. Складываем размеры всех отдельных множеств (++).
  2. Вычитаем размеры всех парных пересечений (-).
  3. Прибавляем размеры всех тройных пересечений (++).
  4. Вычитаем пересечения четверок (-), и так далее, пока не дойдем до пересечения всех nn множеств.

Математически для семейства множеств A1,A2,,AnA_1, A_2, \dots, A_n формула выглядит следующим образом:

i=1nAi=i=1nAi1i<jnAiAj+1i<j<knAiAjAk+(1)n1A1An\left| \bigcup_{i=1}^n A_i \right| = \sum_{i=1}^n |A_i| - \sum_{1 \leq i < j \leq n} |A_i \cap A_j| + \sum_{1 \leq i < j < k \leq n} |A_i \cap A_j \cap A_k| - \dots + (-1)^{n-1} |A_1 \cap \dots \cap A_n|

В этой формуле:

  • Знак i=1nAi\bigcup_{i=1}^n A_i обозначает объединение всех nn множеств.
  • Суммы берутся по всем неупорядоченным наборам индексов: парных пересечений набирается ровно Cn2C_n^2, тройных — Cn3C_n^3, и в общем случае пересечений по mm множеств — ровно CnmC_n^m штук (вспоминаем формулу сочетаний из четвертой главы).
  • Множитель (1)m1(-1)^{m-1} задает чередование знаков: нечетные размеры пересечений входят со знаком плюс, четные — со знаком минус.

Почему формула всегда дает ровно 1: мост к биному Ньютона

Почему эта сложная знакопеременная конструкция гарантированно подсчитывает каждый уникальный элемент ровно один раз, независимо от того, скольким множествам он принадлежит?

Возьмем произвольный объект xx, который входит ровно в kk множеств из nn доступных (1kn1 \leq k \leq n). Посмотрим, какой суммарный вес получит этот объект во всей формуле:

  • В сумме одиночных множеств Ai\sum |A_i| он будет учтен во всех тех множествах, где присутствует, то есть ровно Ck1=kC_k^1 = k раз.
  • В сумме парных пересечений он будет учтен в каждой паре, составленной из «его» kk множеств. Таких пар насчитывается Ck2C_k^2 раз.
  • В тройных пересечениях он учтется Ck3C_k^3 раз, и так далее до пересечений размера kk. В пересечения размера k+1k + 1 и выше объект xx физически войти не может, там его вклад равен нулю.

Соберем все слагаемые веса объекта xx вместе:

Итоговый вес x=Ck1Ck2+Ck3Ck4++(1)k1Ckk\text{Итоговый вес } x = C_k^1 - C_k^2 + C_k^3 - C_k^4 + \dots + (-1)^{k-1} C_k^k

Теперь вспомним разложение бинома Ньютона для выражения (11)k(1 - 1)^k, изученное в главе о сочетаниях:

0=(11)k=Ck01k(1)0Ck1+Ck2Ck3++(1)kCkk0 = (1 - 1)^k = C_k^0 \cdot 1^k \cdot (-1)^0 - C_k^1 + C_k^2 - C_k^3 + \dots + (-1)^k C_k^k

Поскольку Ck0=1C_k^0 = 1, перенесем все остальные члены в левую часть уравнения:

Ck1Ck2+Ck3+(1)k1Ckk=Ck0=1C_k^1 - C_k^2 + C_k^3 - \dots + (-1)^{k-1} C_k^k = C_k^0 = 1

Магия биномиальных коэффициентов гарантирует: для любого k1k \geq 1 знакопеременная сумма сочетаний тождественно равна единице. Никакой элемент не теряется и не дублируется.

Классическая задача комбинаторики: беспорядки

Принцип включений-исключений незаменим не только для подсчета простых баз данных, но и для решения структурных задач теории перестановок. Наиболее известная из них — задача о беспорядках (derangements).

Беспорядок (или субфакториал, обозначаемый !n!n или DnD_n) — это перестановка nn различных элементов, в которой ни один элемент не остается на своей исходной позиции.

Классическая формулировка задачи: nn гостей сдали свои шляпы в гардероб, а рассеянный гардеробщик выдает их обратно в случайном порядке. Каково число способов !n!n вернуть шляпы так, чтобы ни один гость не получил свой собственный головной убор? И какова вероятность такого события?

Применим метод от противного. Общее число всех возможных перестановок из nn элементов нам известно из второй главы — это факториал n!n!.

Определим «неблагоприятные» множества AiA_i (i=1,,ni = 1, \dots, n): событие, при котором ii-й гость получил свою родную шляпу. Нас интересуют исходы, не попавшие ни в одно из множеств AiA_i.

  1. Зафиксируем одного конкретного гостя на своем месте. Остальные n1n - 1 шляп можно распределить произвольно (n1)!(n - 1)! способами. Всего таких одиночных событий nn, то есть Cn1C_n^1.
  2. Зафиксируем двух конкретных гостей на своих местах. Оставшиеся n2n - 2 шляп распределяются (n2)!(n - 2)! способами. Таких пар Cn2C_n^2.
  3. Для mm фиксированных гостей число способов равно (nm)!(n - m)!, а число таких наборов гостей — CnmC_n^m.

Применим принцип включений-исключений для объединения свойств:

A1An=m=1n(1)m1Cnm(nm)!|A_1 \cup \dots \cup A_n| = \sum_{m=1}^n (-1)^{m-1} C_n^m (n - m)!

Распишем биномиальный коэффициент CnmC_n^m через факториалы:

Cnm(nm)!=n!m!(nm)!(nm)!=n!m!C_n^m (n - m)! = \frac{n!}{m!(n - m)!} (n - m)! = \frac{n!}{m!}

Тогда число беспорядков !n!n равно разности между всеми перестановками n!n! и теми, где хотя бы один элемент остался на месте:

!n=n!A1An=n!m=1n(1)m1n!m!=n!m=0n(1)mm!!n = n! - |A_1 \cup \dots \cup A_n| = n! - \sum_{m=1}^n (-1)^{m-1} \frac{n!}{m!} = n! \sum_{m=0}^n \frac{(-1)^m}{m!}

Раскроем скобки:

!n=n!(111!+12!13!++(1)nn!)!n = n! \left( 1 - \frac{1}{1!} + \frac{1}{2!} - \frac{1}{3!} + \dots + \frac{(-1)^n}{n!} \right)

В этой формуле:

  • n!n! — общее число перестановок nn элементов.
  • Выражение в скобках — сумма первых членов ряда Тейлора для экспоненты exe^x в точке x=1x = -1.

Поделив число благоприятных исходов !n!n на общее число исходов n!n!, получим вероятность P(Dn)P(D_n) того, что произойдет полный беспорядок:

P(Dn)=!nn!=11+12!13!++(1)nn!1e0,367879P(D_n) = \frac{!n}{n!} = 1 - 1 + \frac{1}{2!} - \frac{1}{3!} + \dots + \frac{(-1)^n}{n!} \approx \frac{1}{e} \approx 0{,}367879

Ряд сходится невероятно быстро: уже при n5n \geq 5 вероятность того, что ни один человек не получит свою вещь при случайной раздаче, практически неотличима от 1/e36,8%1/e \approx 36{,}8\%.

Принцип в вероятности и машинном обучении: границы Бонферрони

В реальных задачах Data Science точный расчет всех слагаемых формулы включений-исключений часто невозможен: если у нас есть n=50n = 50 признаков или моделей, полное число пересечений составляет 250110152^{50} - 1 \approx 10^{15} операций — снова дает о себе знать комбинаторный взрыв.

Однако чередующаяся природа формулы дает мощное прикладное преимущество. Если оборвать знакопеременную сумму на любом шаге, мы получаем строгие верхние и нижние границы для итогового значения — так называемые неравенства Бонферрони.

Для вероятностей совместных событий P(Ai)P(A_i) это выражается цепочкой приближений:

Порядок усечения Оценка Математическое выражение Роль в анализе
1-й порядок Верхняя граница (Union Bound) P(Ai)P(Ai)P\left(\bigcup A_i\right) \leq \sum P(A_i) Оценка вероятности хотя бы одной ошибки
2-й порядок Нижняя граница P(Ai)P(Ai)P(AiAj)P\left(\bigcup A_i\right) \geq \sum P(A_i) - \sum P(A_i \cap A_j) Учет парных корреляций факторов
3-й порядок Верхняя граница P(Ai)сумма (1)сумма (2)+сумма (3)P\left(\bigcup A_i\right) \leq \text{сумма (1)} - \text{сумма (2)} + \text{сумма (3)} Уточненный доверительный интервал

Самое популярное из них — неравенство первого порядка, известное в Data Science как Union Bound (граница объединения событий):

P(A1A2An)i=1nP(Ai)P(A_1 \cup A_2 \cup \dots \cup A_n) \leq \sum_{i=1}^n P(A_i)

Эта граница лежит в основе статистической поправки Бонферрони для множественной проверки гипотез. Если в A/B-тестировании вы одновременно проверяете 20 различных метрик с порогом значимости α=0,05\alpha = 0{,}05, то вероятность ложноположительного срабатывания хотя бы в одной из них (Family-Wise Error Rate) без поправки может достигать:

P(ошибка)20×0,05=1,0P(\text{ошибка}) \leq 20 \times 0{,}05 = 1{,}0

Чтобы суммарный риск ошибки по всем тестам не превышал желаемые 5%5\%, порог значимости для каждого отдельного теста делят на число сравнений: αnew=0,05/20=0,0025\alpha_{\text{new}} = 0{,}05 / 20 = 0{,}0025. Так комбинаторный принцип включений-исключений защищает аналитиков от ложных открытий в экспериментах с большими массивами данных.

Комбинаторные методы в классической вероятности

Комбинаторные методы в классической вероятности

Представьте, что в партию из 100 серверов закрался брак: ровно 10 плат содержат скрытый дефект памяти. Инженер отдела контроля качества случайным образом извлекает 5 плат для нагрузочного тестирования. Какова вероятность того, что проверка выявит хотя бы один бракованный сервер? Бытовая интуиция подсказывает сложить доли: раз брак составляет 10%10\%, то при выборке в 5 штук шанс должен быть около половины (5×10%=50%5 \times 10\% = 50\%). Однако честный расчет показывает лишь 41,6%41{,}6\%. Линейная логика дает грубый промах почти в 10 процентных пунктов, потому что каждый шаг случайного выбора не просто уменьшает генеральную совокупность, но и непрерывно перекраивает доли оставшихся исходов.

Все комбинаторные конструкции — от правил суммы и произведения до перестановок, сочетаний и принципа включений-исключений — создавались ради одного момента: точно очерчивать пространства элементарных исходов и превращать комбинаторный подсчет в вероятностный прогноз.


Пространство исходов и требование равновозможности

Классическое определение вероятности опирается на модель дискретного случайного эксперимента. Любое единичное испытание завершается одним из неделимых результатов, которые называют элементарными исходами. Их полное множество обозначают греческой буквой Ω\Omega (омега). Интересующее нас событие AA — это просто некоторое подмножество исходов внутри Ω\Omega, благоприятствующих условию задачи: AΩA \subseteq \Omega.

Классическая вероятность события — это отношение числа элементарных исходов, благоприятствующих наступлению события AA, к общему числу всех возможных элементарных исходов в пространстве Ω\Omega:

P(A)=AΩ=mNP(A) = \frac{|A|}{|\Omega|} = \frac{m}{N}

где A=m|A| = m — мощность множества благоприятных исходов, а Ω=N|\Omega| = N — общая мощность пространства элементарных исходов.

В этой компактной формуле скрыто критическое ограничение, о котором часто забывают: все исходы из Ω\Omega обязаны быть строго равновозможными.

Если мы бросаем несимметричный кубик или делим исходы на два субъективных класса («встречу динозавра на улице» или «не встречу»), формула Лапласа теряет смысл. Ошибка начинающих в вероятностных задачах кроется не в арифметике деления mm на NN, а в некорректном конструировании множества Ω\Omega.

Рассмотрим фундаментальный принцип согласованности числителя и знаменателя:

Подход к формированию Ω\Omega Множество всех исходов Ω\Omega Подмножество успехов AA Когда применять
Упорядоченный (с учетом позиций) Размещения AnkA_n^k или кортежи nkn^k Цепочки с фиксацией порядка выпадения Когда важно, в какой именно момент наступило событие
Неупорядоченный (без учета позиций) Сочетания CnkC_n^k Подмножества фиксированного состава Когда важен только итоговый состав выборки

Главное правило моделирования: нельзя смешивать порядки. Если общее число исходов Ω|\Omega| подсчитано через неупорядоченные сочетания, то и благоприятные исходы A|A| обязаны рассчитываться строго через сочетания. Переход к упорядоченным размещениям в числителе при сочетаниях в знаменателе мгновенно завысит вероятность в k!k! раз.


Выборка без возвращения: гипергеометрическая модель

В Data Science и статистике большинство задач контроля качества, A/B-тестирования без повторов и валидации датасетов сводятся к так называемой «урновой схеме»: в генеральной совокупности объема NN есть ровно MM целевых объектов («успехов») и NMN - M фоновых («неудач»). Мы извлекаем случайную подвыборку размером nn объектов без возвращения. Какова вероятность получить ровно kk целевых объектов?

Каждый извлекаемый объект меняет состав оставшейся совокупности. Поскольку порядок извлечения элементов в итоговом срезе данных нам безразличен, мы переходим на язык сочетаний.

Число всех способов извлечь nn элементов из совокупности NN равно числу сочетаний CNnC_N^n. Это наш знаменатель Ω|\Omega|.

Чтобы получить ровно kk успехов, мы обязаны одновременно реализовать два независимых подвыбора:

  1. Выбрать ровно kk целевых объектов из MM доступных: на это есть CMkC_M^k способов.
  2. «Добежать» остаток выборки размером nkn - k исключительно за счет нецелевых объектов, которых всего NMN - M: на это есть CNMnkC_{N-M}^{n-k} способов.

По правилу умножения общее количество благоприятных конфигураций равно их произведению. Так рождается классическая формула гипергеометрической вероятности:

P(X=k)=CMkCNMnkCNnP(X = k) = \frac{C_M^k \cdot C_{N - M}^{n - k}}{C_N^n}

Разберем параметры этой конструкции:

  • NN — общий объем совокупности (размер базы, батча, датасета).
  • MM — количество целевых элементов в генеральной совокупности (MNM \leq N).
  • nn — объем извлекаемой случайной выборки (nNn \leq N).
  • kk — требуемое количество целевых элементов в выборке (0kmin(n,M)0 \leq k \leq \min(n, M)).

Вернемся к вопросу из вводной части: партия из N=100N = 100 серверов, брак M=10M = 10, выборка n=5n = 5. Событие AA — «обнаружен хотя бы один бракованный сервер» (k1k \geq 1).

Прямой подсчет через объединение вариантов k=1,2,3,4,5k = 1, 2, 3, 4, 5 громоздок. Элегантнее перейти к противоположному событию A\overline{A} — «в выборке 0 бракованных серверов» (k=0k = 0):

P(A)=C100C905C1005=190898887865!100999897965!=9089888786100999897960,5838P(\overline{A}) = \frac{C_{10}^0 \cdot C_{90}^5}{C_{100}^5} = \frac{1 \cdot \frac{90 \cdot 89 \cdot 88 \cdot 87 \cdot 86}{5!}}{\frac{100 \cdot 99 \cdot 98 \cdot 97 \cdot 96}{5!}} = \frac{90 \cdot 89 \cdot 88 \cdot 87 \cdot 86}{100 \cdot 99 \cdot 98 \cdot 97 \cdot 96} \approx 0{,}5838

Поскольку сумма вероятностей взаимоисключающих противоположных событий равна единице (P(A)+P(A)=1P(A) + P(\overline{A}) = 1), искомая вероятность равна:

P(A)=1P(A)10,5838=0,4162(41,62%)P(A) = 1 - P(\overline{A}) \approx 1 - 0{,}5838 = 0{,}4162 \quad (41{,}62\%)

Тот же самый результат получится, если моделировать эксперимент как цепочку зависимых шагов по правилу умножения: шанс взять первым исправный сервер равен 90/10090/100, вторым — 89/9989/99, третьим — 88/9888/98 и так далее. Комбинаторика сочетаний CNnC_N^n избавляет нас от анализа пошаговых условных вероятностей, решая задачу в один компактный шаг.


Сходимость гипергеометрической модели к биномиальной

Что произойдет, если размер генеральной совокупности NN огромен по сравнению с размером подвыборки nn (например, мы опрашиваем n=100n = 100 клиентов интернет-магазина с базой N=1000000N = 1\,000\,000 пользователей)?

При извлечении одного пользователя доля целевого сегмента p=M/Np = M / N практически не изменяется:

  • До первого шага доля успеха составляла pp.
  • Если мы вытащили целевой объект, на втором шаге доля станет (M1)/(N1)M/N=p(M - 1) / (N - 1) \approx M / N = p.

Зависимость между последовательными шагами выборки без возвращения исчезает. Гипергеометрическая схема (выборка без возвращения) вырождается в биномиальную схему Бернулли (выборка с возвращением):

P(X=k)=Cnkpk(1p)nkP(X = k) = C_n^k \cdot p^k \cdot (1 - p)^{n - k}

где p=MNp = \frac{M}{N} — фиксированная вероятность успеха на каждом шаге.

В анализе данных эмпирическое правило гласит: если объем выборки составляет менее 5–10% от совокупности (n/N<0,05n / N < 0{,}05), то поправкой на отсутствие возвращения можно пренебречь и использовать более простую вычислительно биномиальную формулу. Если же выборка затрагивает существенную долю датасета (аудит малых выборок, редкие классы, стратифицированное тестирование), учет комбинаторной структуры гипергеометрического распределения обязателен.


Сложные события и принцип включений-исключений в вероятности

До сих пор мы рассматривали события, которые легко разбивались на непересекающиеся группы. Но в реальных распределенных системах события регулярно накладываются друг на друга: узлы кластера выходят из строя по пересекающимся причинам, рекламные кампании показывают баннеры одной и той же аудитории, а пользователи генерируют дублирующиеся конверсии.

Если события AA и BB совместны (то есть их пересечение ABA \cap B \neq \varnothing), простое сложение вероятностей P(A)+P(B)P(A) + P(B) приведет к ошибке: элементарные исходы из зоны пересечения будут посчитаны дважды.

Комбинаторный принцип включений-исключений напрямую транслируется на язык вероятностной меры:

Теорема сложения для двух совместных событий:

P(AB)=P(A)+P(B)P(AB)P(A \cup B) = P(A) + P(B) - P(A \cap B)

Для трех совместных событий:

P(ABC)=P(A)+P(B)+P(C)(P(AB)+P(AC)+P(BC))+P(ABC)P(A \cup B \cup C) = P(A) + P(B) + P(C) - \big(P(A \cap B) + P(A \cap C) + P(B \cap C)\big) + P(A \cap B \cap C)

Поясним смысл элементов:

  • P(AB)P(A \cup B) — вероятность того, что произойдет хотя бы одно из событий (AA или BB, или оба сразу).
  • P(A),P(B)P(A), P(B) — индивидуальные вероятности событий.
  • P(AB)P(A \cap B) — вероятность одновременного наступления обоих событий, вычитаемая для устранения двойного учета.

Разберем инженерный кейс. Сервис рекомендаций развернут на трех независимых серверах кэширования: S1S_1, S2S_2, S3S_3. Каждый сервер независимо испытывает пиковую перегрузку в течение суток с вероятностями:

  • P(S1)=0,20P(S_1) = 0{,}20
  • P(S2)=0,15P(S_2) = 0{,}15
  • P(S3)=0,10P(S_3) = 0{,}10

Из-за общего сетевого шлюза сбои серверов частично скоррелированы:

  • Попарные вероятности одновременного отказа: P(S1S2)=0,05P(S_1 \cap S_2) = 0{,}05, P(S1S3)=0,04P(S_1 \cap S_3) = 0{,}04, P(S2S3)=0,03P(S_2 \cap S_3) = 0{,}03.
  • Вероятность одновременного падения всех трех серверов: P(S1S2S3)=0,01P(S_1 \cap S_2 \cap S_3) = 0{,}01.

Какова вероятность того, что система рекомендаций потеряет хотя бы один сервер кэша за сутки?

Подставляем значения в формулу:

P(S1S2S3)=(0,20+0,15+0,10)(0,05+0,04+0,03)+0,01=0,450,12+0,01=0,34(34%)P(S_1 \cup S_2 \cup S_3) = (0{,}20 + 0{,}15 + 0{,}10) - (0{,}05 + 0{,}04 + 0{,}03) + 0{,}01 = 0{,}45 - 0{,}12 + 0{,}01 = 0{,}34 \quad (34\%)

Если бы мы наивно сложили вероятности по правилу сложения, получили бы 0,450{,}45 (45%45\%), а если бы проигнорировали тройное пересечение — получили бы заниженную оценку 0,330{,}33.

В ситуациях, когда совместные вероятности высоких порядков оценить трудно, в машинном обучении применяют неравенство Буля (первое приближение Бонферрони): P(Ai)P(Ai)P(\bigcup A_i) \leq \sum P(A_i). Оно гарантирует строгую верхнюю границу риска даже при неизвестной структуре взаимосвязей.


Синтез курса: навигатор комбинаторных моделей

Мы начали путь с элементарных правил сложения и умножения вариантов, освоили перестановки, классифицировали размещения и сочетания, научились работать с неразличимыми повторениями и пересекающимися множествами. Классическая теория вероятностей собирает эти инструменты в единую инженерную систему.

Когда перед аналитиком встает задача оценить вероятность редкого события, сценария отказа или статистической значимости эксперимента, алгоритм выбора комбинаторной базы выглядит следующим образом:

  1. Определите тип выборки:
    • Порядок важен, повторений нет \to Размещения без повторений AnkA_n^k.
    • Порядок важен, элементы возвращаются \to Размещения с повторениями nkn^k.
    • Порядок безразличен, выборка уникальна \to Сочетания CnkC_n^k (гипергеометрическая база).
    • Порядок безразличен, категории с повторениями \to Сочетания с повторениями (метод перегородок).
  2. Синхронизируйте числитель и знаменатель:
    • Любое допущение, сделанное при расчете общего пространства Ω|\Omega| (учет уникальности меток объектов, фиксация последовательности), обязано зеркально соблюдаться при расчете благоприятных исходов A|A|.
  3. Проверьте независимость и совместность:
    • При выборке с возвращением из больших генеральных совокупностей переходите к биномиальным моделям.
    • При пересечении условий используйте знакопеременное суммирование принципа включений-исключений.

Комбинаторика — это не изолированный раздел дискретной математики с формулами из учебника, а фундаментальный язык описания пространств состояний. Умение декомпозировать сложные события на элементарные исходы дает Data Scientist'у возможность строго оценивать вероятности, проектировать корректные статистические тесты и не допускать иллюзорных выводов там, где данные диктуют строгий математический закон.